 UPDF
 UPDF für Windows
 UPDF für Mac
 UPDF für iPhone/iPad
 UPDF für Android
 Nomostar
 UPDF AI Online
 UPDF Sign
 IvyCraft
 PDF bearbeiten
 PDF kommentieren
 PDF erstellen
 PDF-Formular
 Links bearbeiten
 PDF konvertieren
 OCR
 PDF in Word
 PDF in Bild
 PDF in Excel
 PDF organisieren
 PDFs zusammenführen
 PDF teilen
 PDF zuschneiden
 PDF drehen
 PDF schützen
 PDF signieren
 PDF schwärzen
 PDF bereinigen
 Sicherheit entfernen
 PDF lesen
 UPDF Cloud
 PDF komprimieren
 PDF drucken
 Stapelverarbeitung
 Über UPDF AI
 UPDF AI Lösungen
 KI-Benutzerhandbuch
 FAQ zu UPDF AI
 PDF zusammenfassen
 PDF übersetzen
 Chatten mit PDF
 Chatten mit AI
 Chatten mit Bild
 PDF zu Mindmap
 PDF erklären
 PDF-KI-Tools
 Bild-KI-Tools
 KI-Chat-Tools
 KI-Schreibtools
 KI-Lerntools
 KI-Arbeitstools
 Weitere KI-Tools
 KI-Lesezeichen-Generierung
 KI-Lesezeichen-Zusammenfassung
 KI-Wasserzeichen-Generierung
 KI-Hintergrund-Generierung
 KI-Sticker-Generierung
 KI-Stempel-Generierung
 KI-Schreibtools
 UPDF Copilot
 KI-Seitenverwaltung
 KI-Semantische Suche
 PDF in Word
 PDF in Excel
 PDF in PowerPoint
 Unternehmenslösung
 Unternehmen Sign
 Unternehmen AI
 Unternehmensplan
 Benutzerhandbuch für Unternehmen
 Unternehmens-Webinar
 Bankwesen
 Gesundheitswesen
 Versicherung
 Rechtlich
 Fertigung
 Regierung
 Bildungsbereich-Lösung
 Kundengeschichten
 Tutorials
 UPDF Tipps
 FAQs
 UPDF Bewertungen
 Downloadcenter
 Blog
 Newsroom
 Technische Daten
 Updates
 UPDF vs. Adobe Acrobat
 UPDF vs. Foxit
 UPDF vs. PDF Expert
Kurz gesagt:
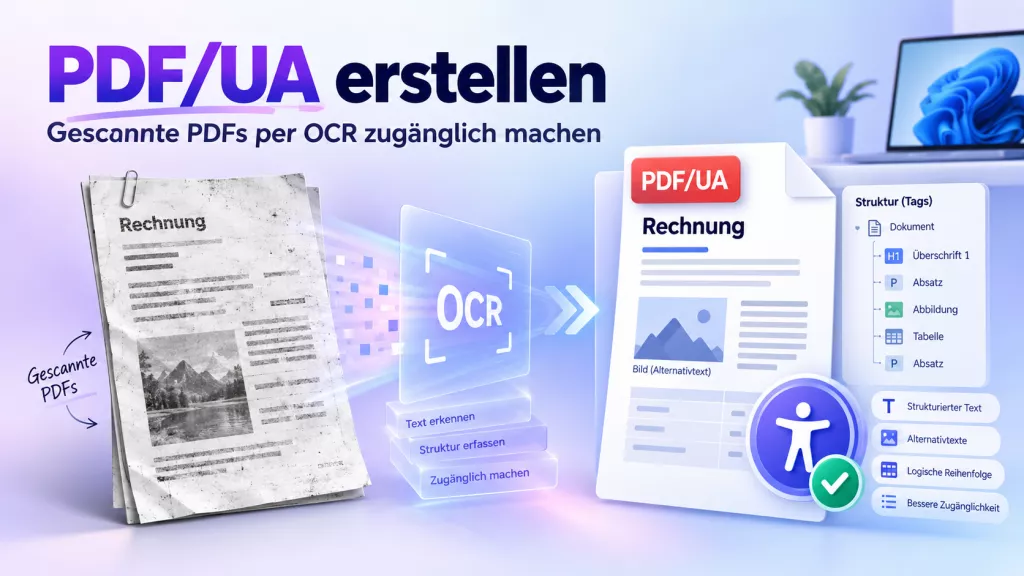
Eine gescannte PDF besteht zunächst lediglich aus Seitenbildern. Der sichtbare Text lässt sich häufig weder durchsuchen noch auswählen und kann von Screenreadern nicht zuverlässig erfasst werden. Damit solche Dokumente besser zugänglich werden, muss der Text zunächst per OCR erkannt und anschließend in einer strukturierten PDF bereitgestellt werden.
PDF/UA schafft dafür eine technische Grundlage. Welcher Arbeitsweg sinnvoll ist, hängt jedoch von der Ausgangsdatei ab: Ein strukturiertes Word-Dokument lässt sich anders vorbereiten als ein alter Vertrag, eine Broschüre oder ein mehrseitiger Scan.
UPDF für Windows bietet für gescannte Dateien einen praktischen Ablauf: Die Software erkennt den Text per OCR und kann das Ergebnis direkt als PDF/UA speichern. In unserem Test erfüllte die exportierte Datei die automatisch prüfbaren PDF/UA- und WCAG-Anforderungen in PAC 2026. Eine zusätzliche Qualitäts- und Praxiskontrolle bleibt dennoch wichtig.
Windows • macOS • iOS • Android 100% sicher
Was ist PDF/UA?
„UA“ steht für „Universal Accessibility“. PDF/UA ist der gebräuchliche Name für die ISO-Normenfamilie 14289. Sie beschreibt technische Anforderungen an PDF-Dokumente, damit deren Inhalte von Screenreadern und anderen assistiven Technologien besser verarbeitet werden können.
Ein gewöhnliches PDF legt in erster Linie fest, wie eine Seite aussieht. Für einen Menschen ist visuell erkennbar, was eine Überschrift, ein Absatz, eine Tabelle oder eine Bildunterschrift ist. Ein Screenreader benötigt dafür zusätzliche Strukturinformationen.
Diese Informationen werden unter anderem durch PDF-Tags bereitgestellt. Sie kennzeichnen beispielsweise:
- Überschriften und Absätze,
- Listen und Listeneinträge,
- Tabellen und Tabellenüberschriften,
- Abbildungen und Alternativbeschreibungen,
- Links und Formularfelder,
- die logische Reihenfolge der Inhalte.
Zusätzlich sollten die Dokument- und Inhaltssprache korrekt festgelegt sein. Ob die erforderlichen Strukturinformationen tatsächlich vorhanden und technisch korrekt umgesetzt sind, lässt sich anschließend mit einem Accessibility-Checker überprüfen. Die PDF Association erklärt ausführlich, wie Tagged PDF und PDF/UA den Zugang zu Dokumentinhalten unterstützen.
Welcher Weg passt zu Ihrer Ausgangsdatei?
Nicht jedes Dokument sollte auf dieselbe Weise verarbeitet werden.
| Ausgangsdatei | Empfohlener Arbeitsweg |
|---|---|
| Strukturiertes Word- oder Office-Dokument | Überschriften, Listen, Tabellen und Alternativtexte in der Quelldatei richtig anlegen und anschließend barrierefrei exportieren |
| Digital erstellte PDF ohne brauchbare Tags | Struktur, Tags und Lesereihenfolge mit einer spezialisierten Anwendung nachbearbeiten |
| Gescannte PDF | Unter Windows OCR durchführen und das Ergebnis mit UPDF als PDF/UA speichern |
| Komplexes Formular oder mehrspaltiges Dokument | Automatische Verarbeitung mit manueller Reparatur und professioneller Prüfung kombinieren |
| Bereits vorhandene PDF/UA | Technische Prüfung und manuellen Praxistest durchführen |
Diese Unterscheidung ist wichtig, weil das Speichern in einem neuen Format nicht automatisch alle Barrieren des Ausgangsdokuments beseitigt.
Warum gescannte PDFs besonders problematisch sind
Bei einem Scan besteht jede Seite zunächst aus einem Bild. Auf dem Bildschirm sieht der Inhalt zwar wie normaler Text aus, technisch fehlen jedoch Buchstaben, Wörter und Absätze.
Dadurch entstehen typische Einschränkungen:
- Text kann nicht markiert oder kopiert werden.
- Die Suchfunktion findet keine Namen oder Begriffe.
- Screenreader erkennen häufig nur ein Bild.
- Inhalte lassen sich nicht sinnvoll vorlesen.
- Zahlen und Textstellen müssen manuell übertragen werden.
- Das Dokument kann kaum weiterbearbeitet werden.
OCR steht für „Optical Character Recognition“, also optische Zeichenerkennung. Die Technologie analysiert die Seitenbilder und erzeugt daraus eine maschinenlesbare Textebene.
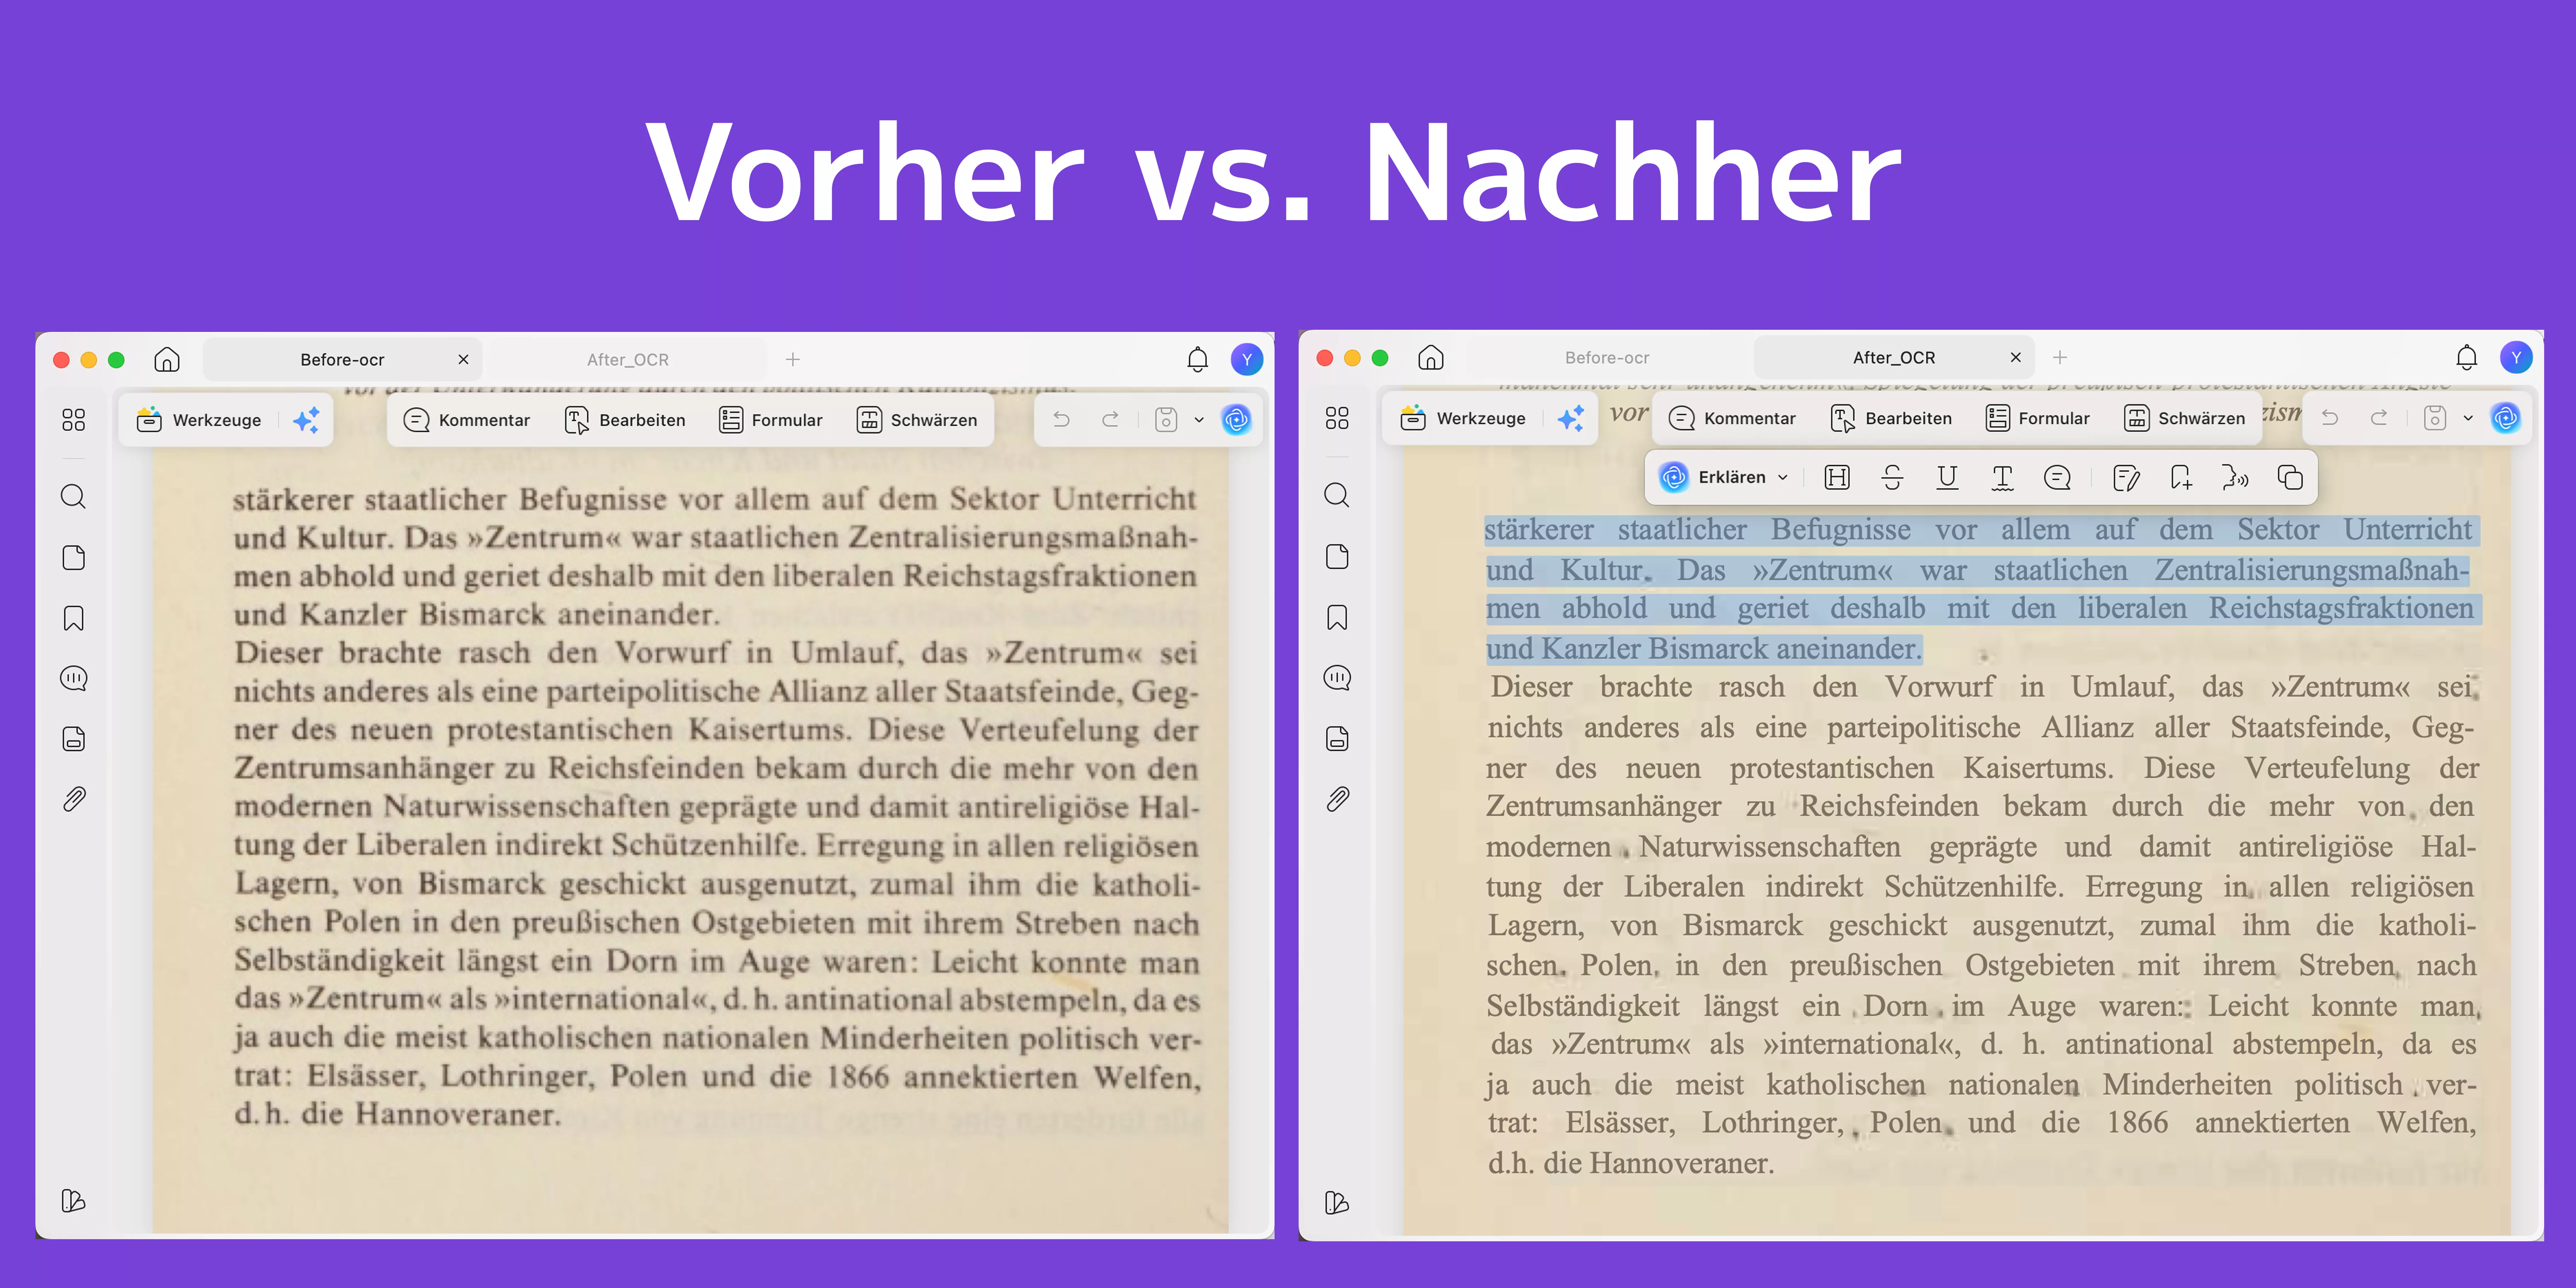
Damit wird aus einem reinen Scan eine Datei, deren Text grundsätzlich durchsucht, ausgewählt und weiterverarbeitet werden kann. OCR allein erzeugt jedoch noch keine perfekte Überschriftenstruktur, Lesereihenfolge oder vollständige Alternativtexte.
Gescannte PDF unter Windows als PDF/UA speichern
UPDF für Windows kann OCR-Ergebnisse als PDF/UA-Datei ausgeben. Der Arbeitsablauf eignet sich besonders für textbasierte Briefe, Verträge, Berichte, Lernmaterialien und eingescannte Verwaltungsunterlagen.
Systemhinweis: Die Option „Als PDF/UA speichern“ ist derzeit nur in UPDF für Windows und innerhalb der OCR-Funktion verfügbar. UPDF für Mac, iOS und Android bietet diese Option aktuell nicht an.
Schritt 1: Scan in UPDF öffnen
Starten Sie UPDF für Windows und öffnen Sie die gescannte PDF-Datei.
Windows • macOS • iOS • Android 100% sicher
Kontrollieren Sie vor der Texterkennung:
- Sind alle Seiten vorhanden?
- Sind die Seiten korrekt ausgerichtet?
- Ist der Text ausreichend scharf?
- Sind Seitenränder abgeschnitten?
- Enthält das Dokument Handschrift oder ungewöhnliche Schriftarten?
Eine gute Scanqualität verbessert die Wahrscheinlichkeit einer korrekten OCR-Erkennung.
Schritt 2: OCR-Texterkennung starten
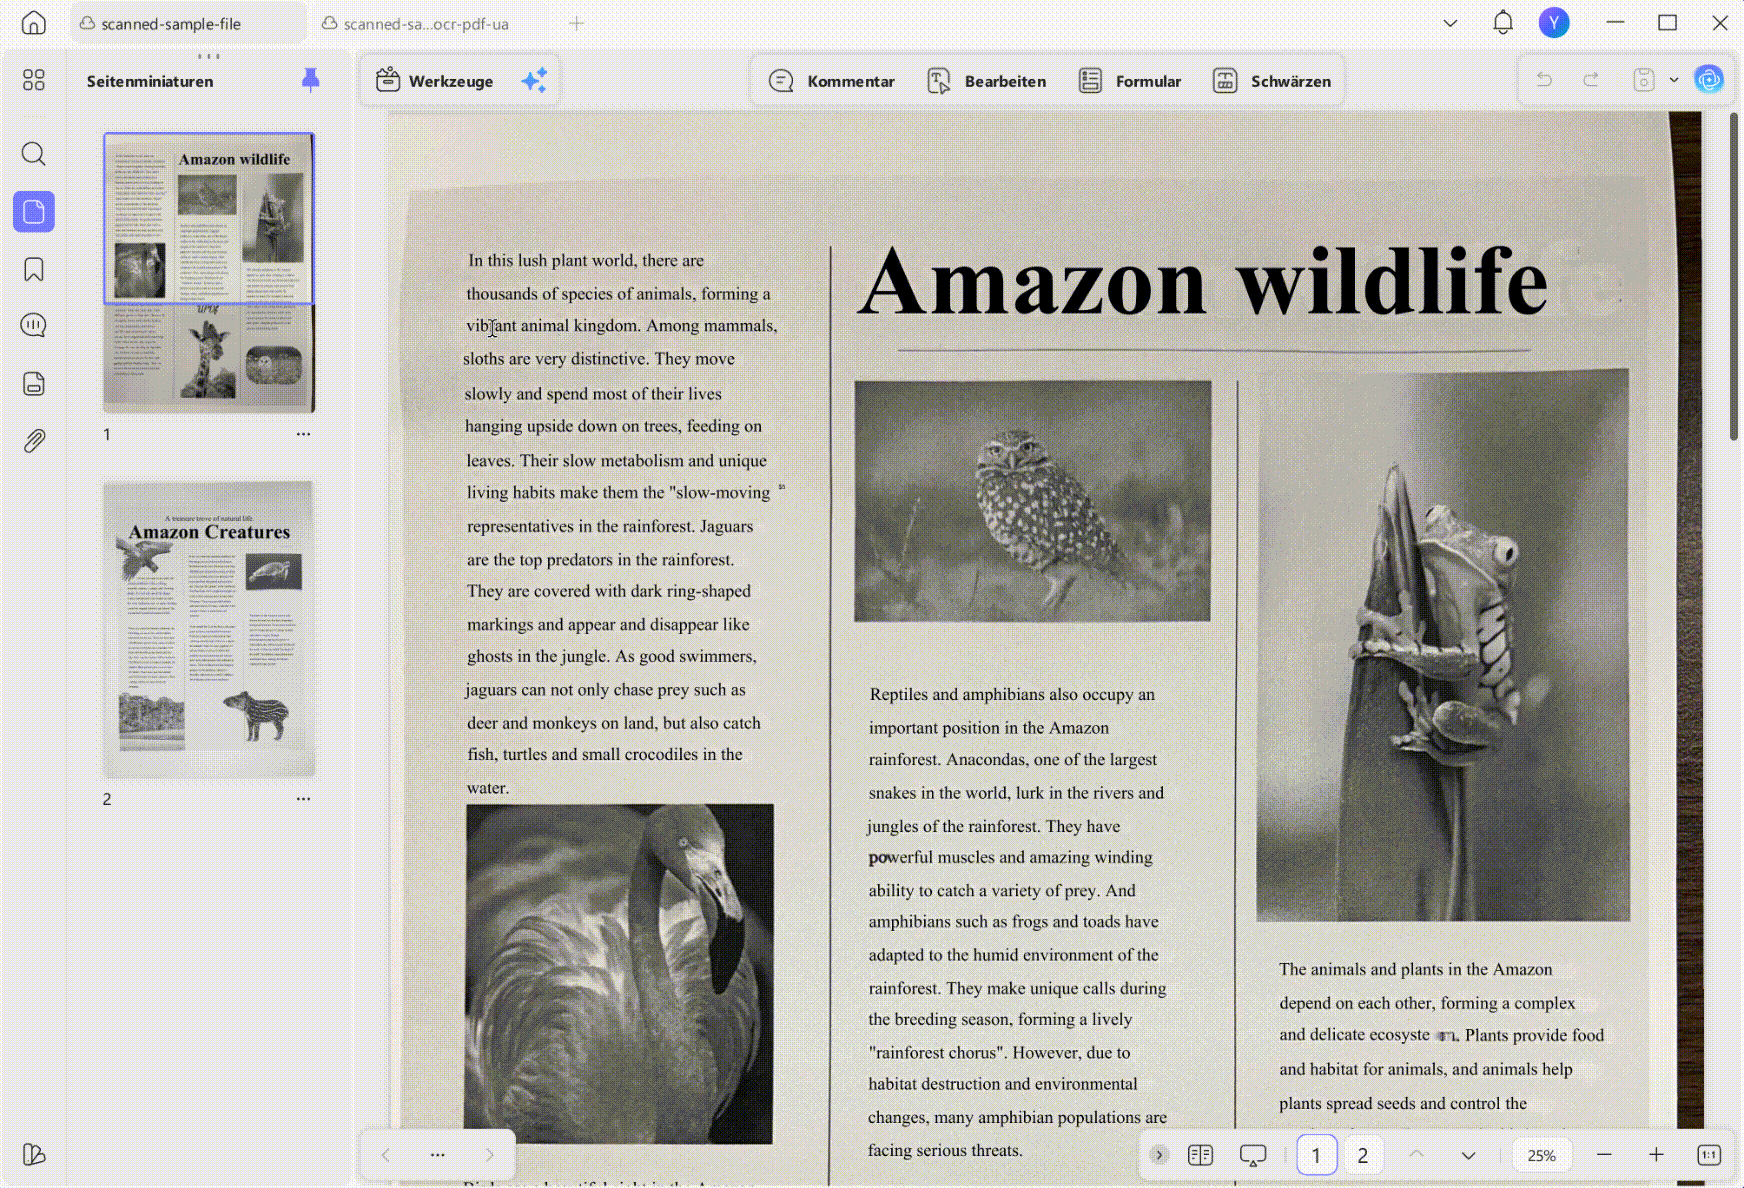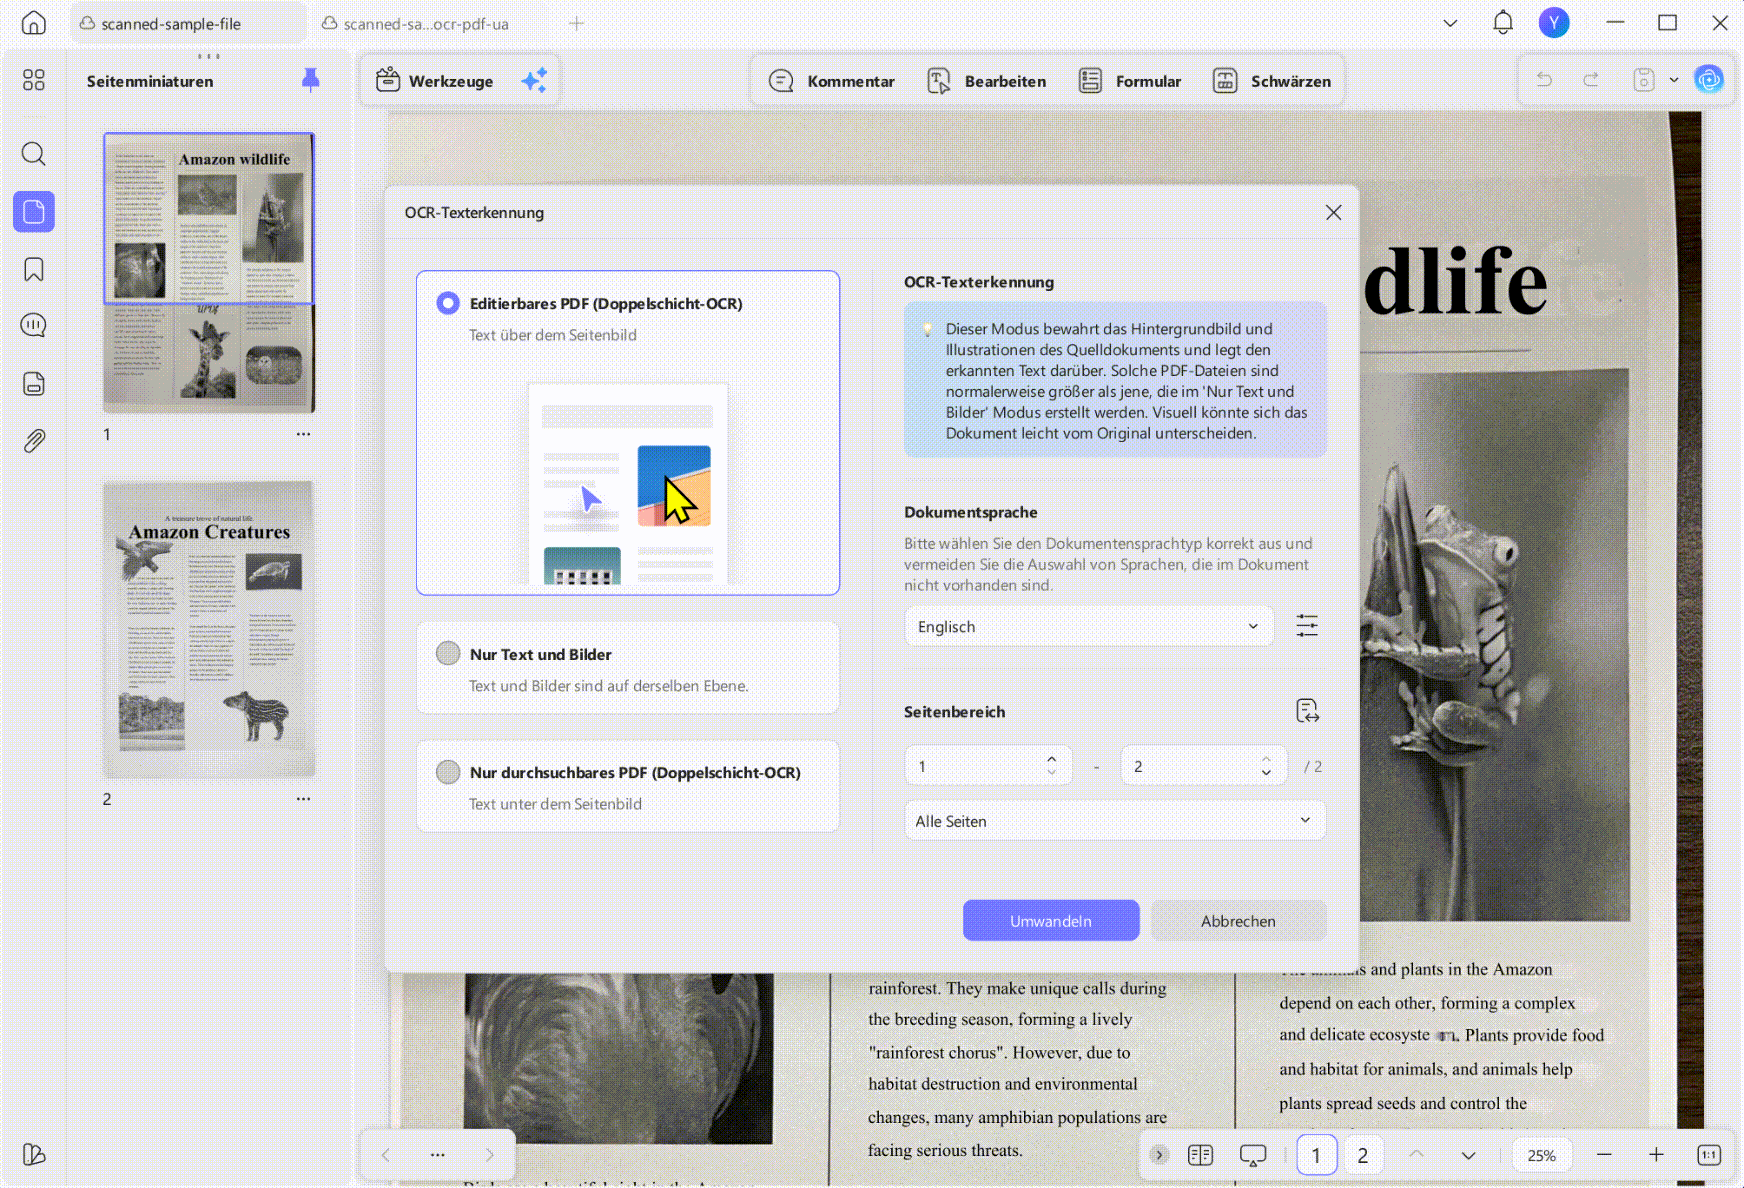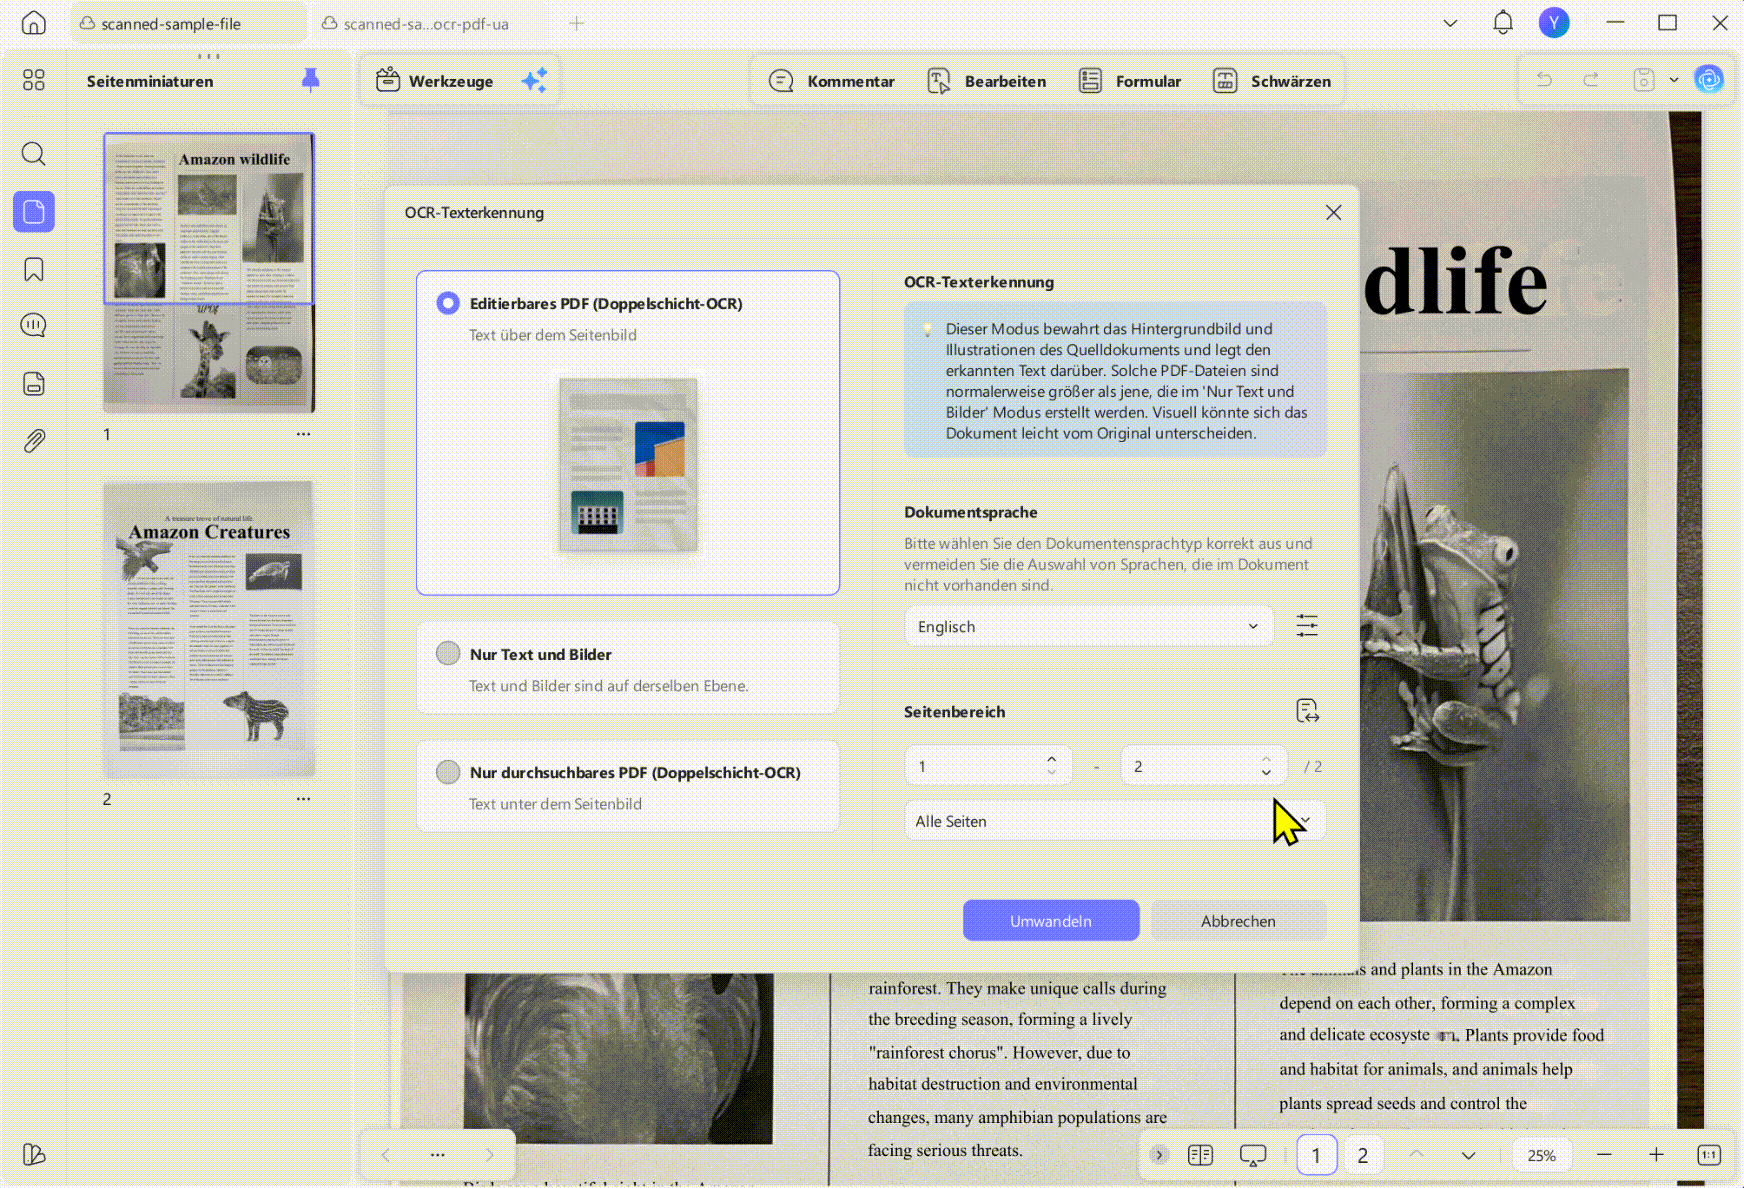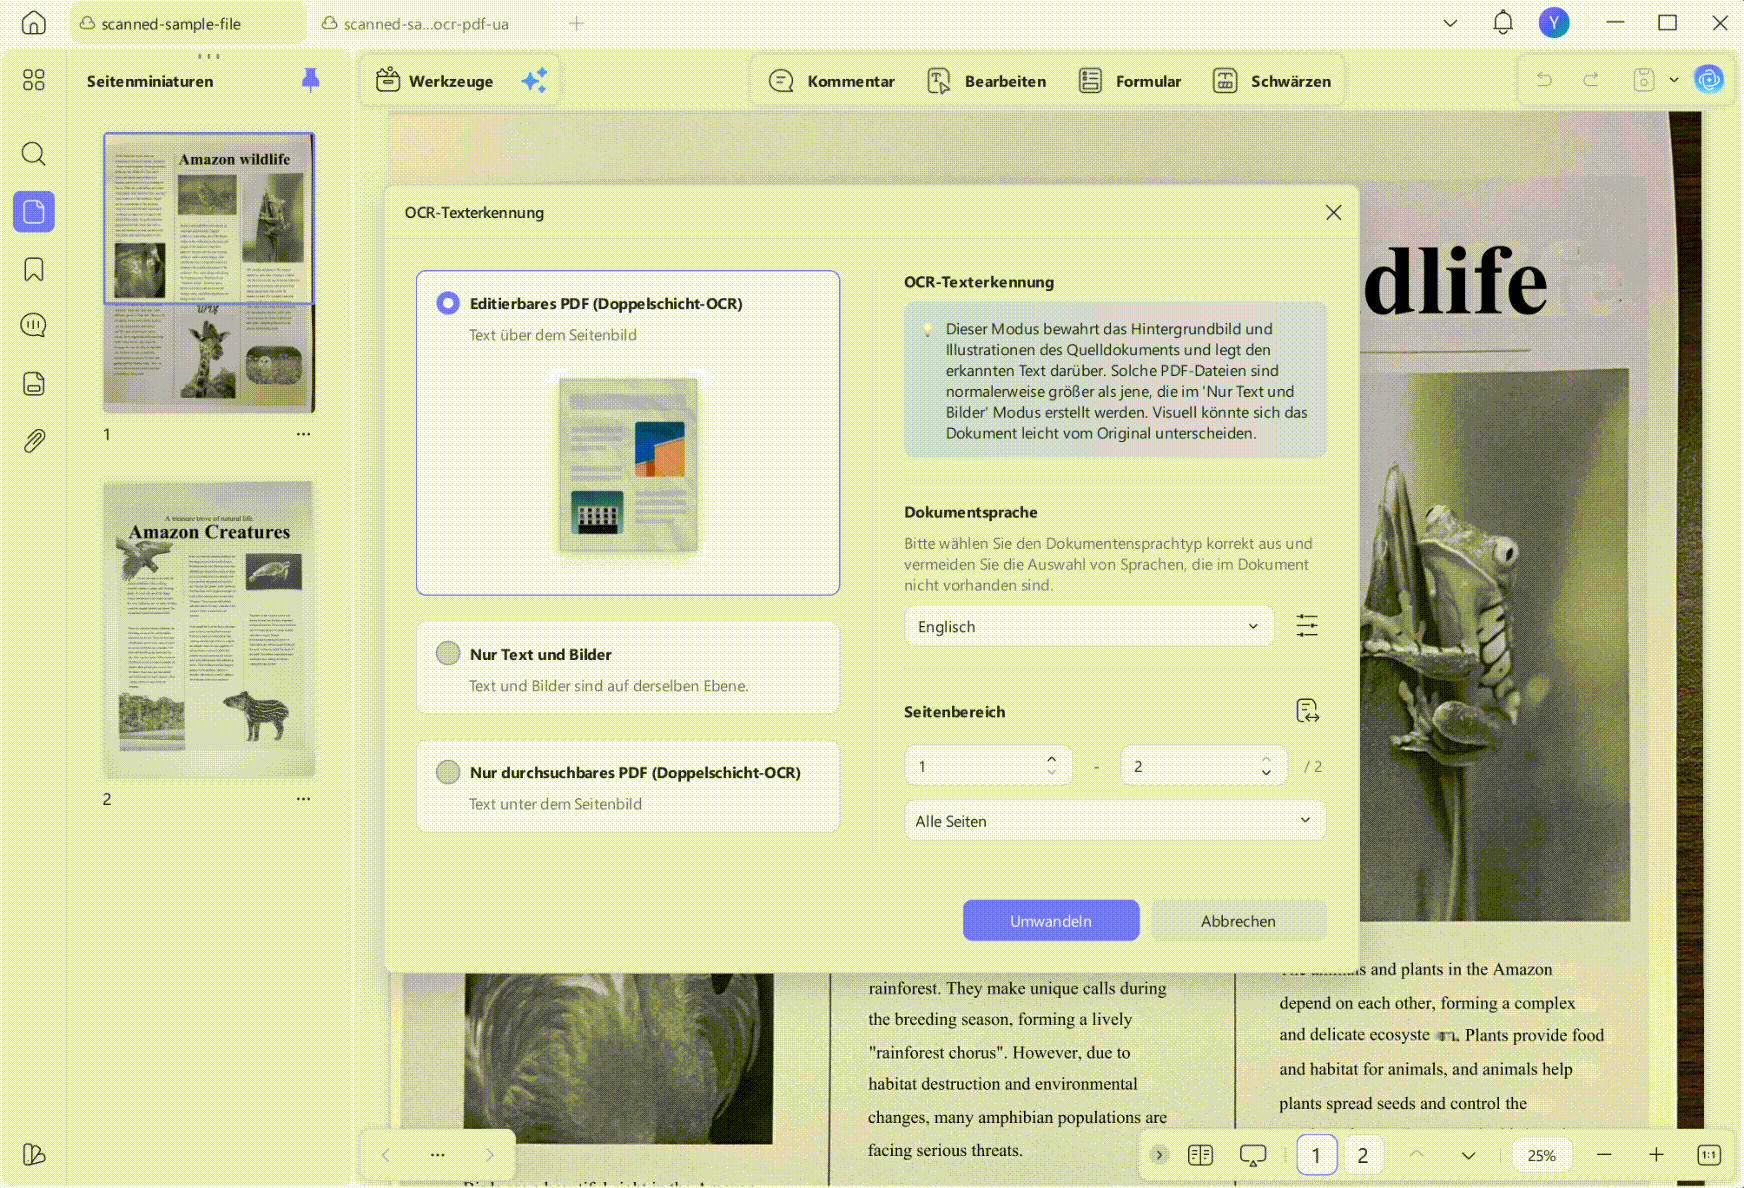
Öffnen Sie die OCR-Funktion und wählen Sie die Sprache des Dokuments. Bei einem deutschen Dokument sollte „Deutsch“ ausgewählt werden, damit Umlaute und typische Wortformen möglichst zuverlässig erkannt werden.
Legen Sie außerdem fest, ob alle Seiten oder nur ein bestimmter Seitenbereich verarbeitet werden sollen.
Schritt 3: OCR-Ausgabe auswählen
Wählen Sie einen geeigneten OCR-Modus. Für Dokumente, die anschließend durchsucht und gegebenenfalls bearbeitet werden sollen, können Sie beispielsweise „Editierbares PDF (Doppelschicht-OCR)“ verwenden.
Abhängig vom Dokument können unterschiedliche Ergebnisse sinnvoll sein. Prüfen Sie deshalb, ob die Datei vor allem bearbeitbar sein oder das ursprüngliche Erscheinungsbild möglichst genau bewahren soll.
Schritt 4: PDF/UA aktivieren
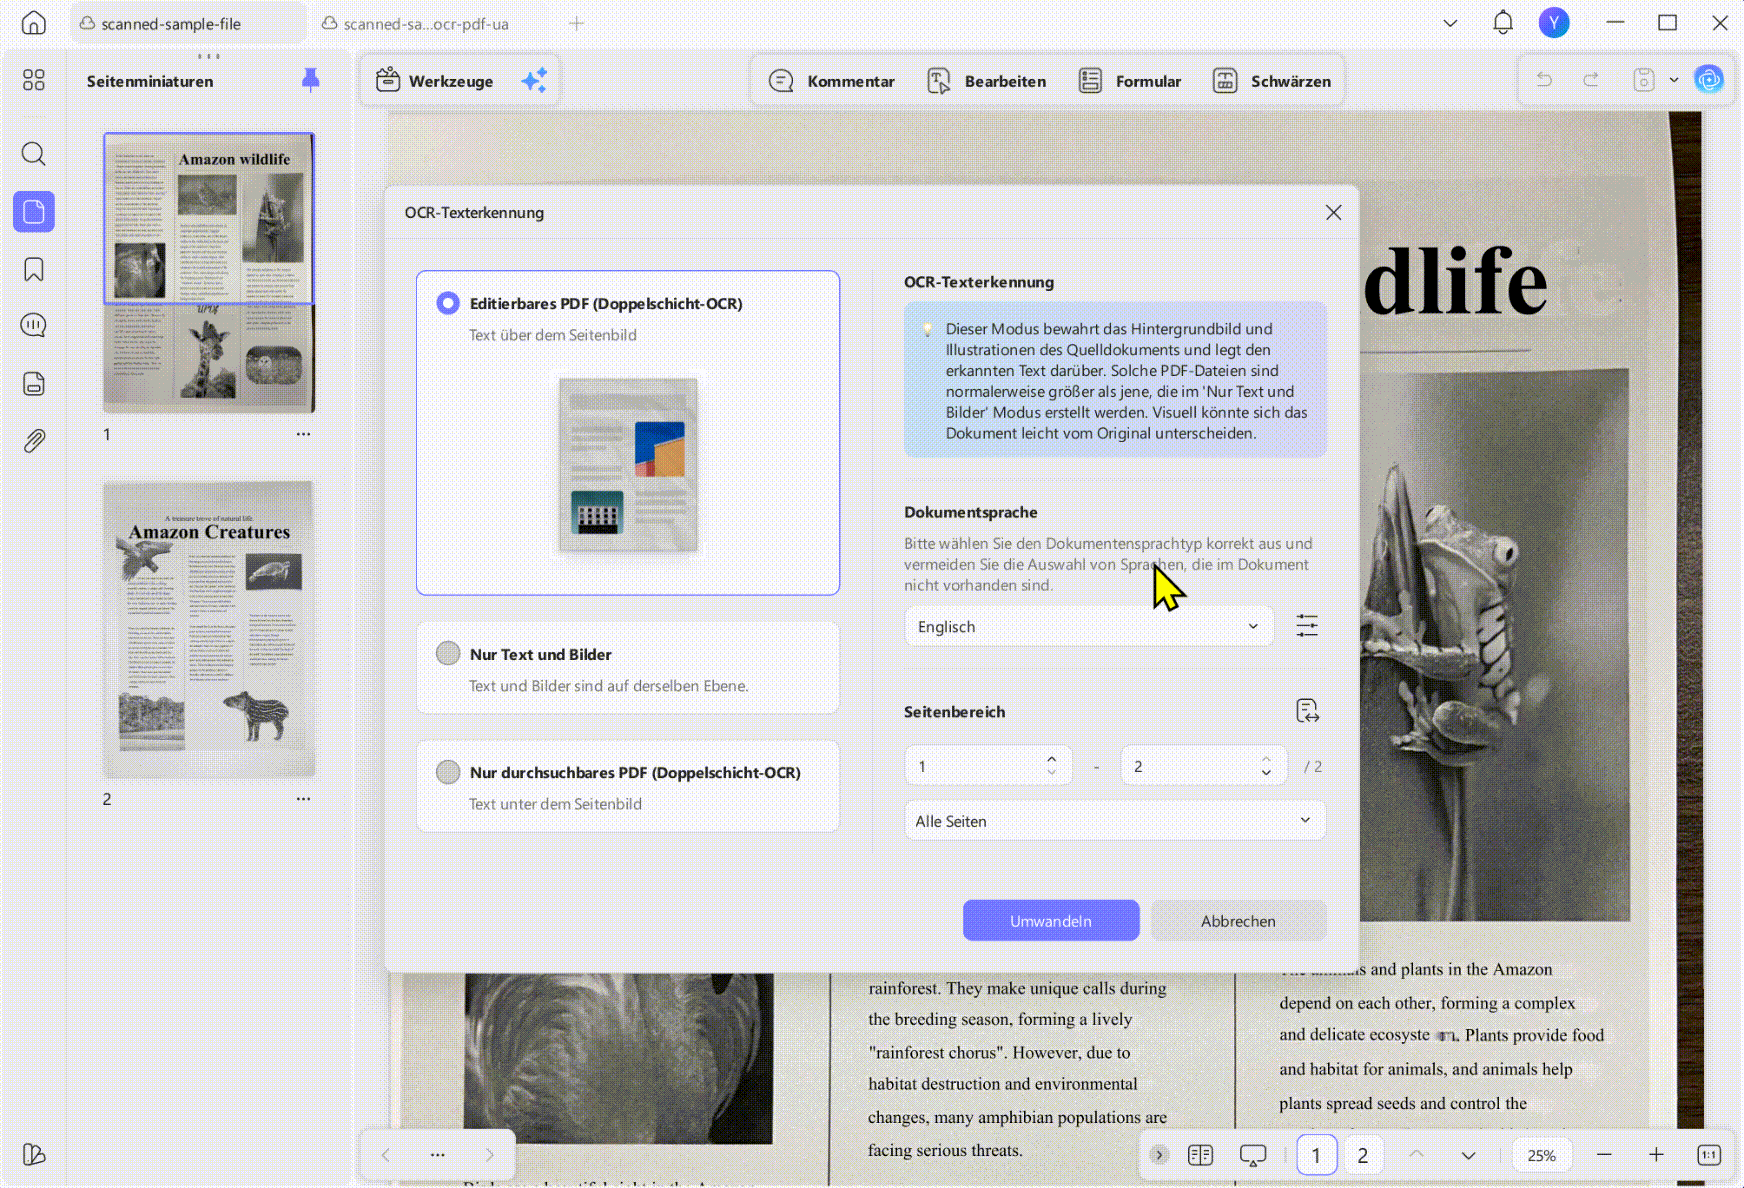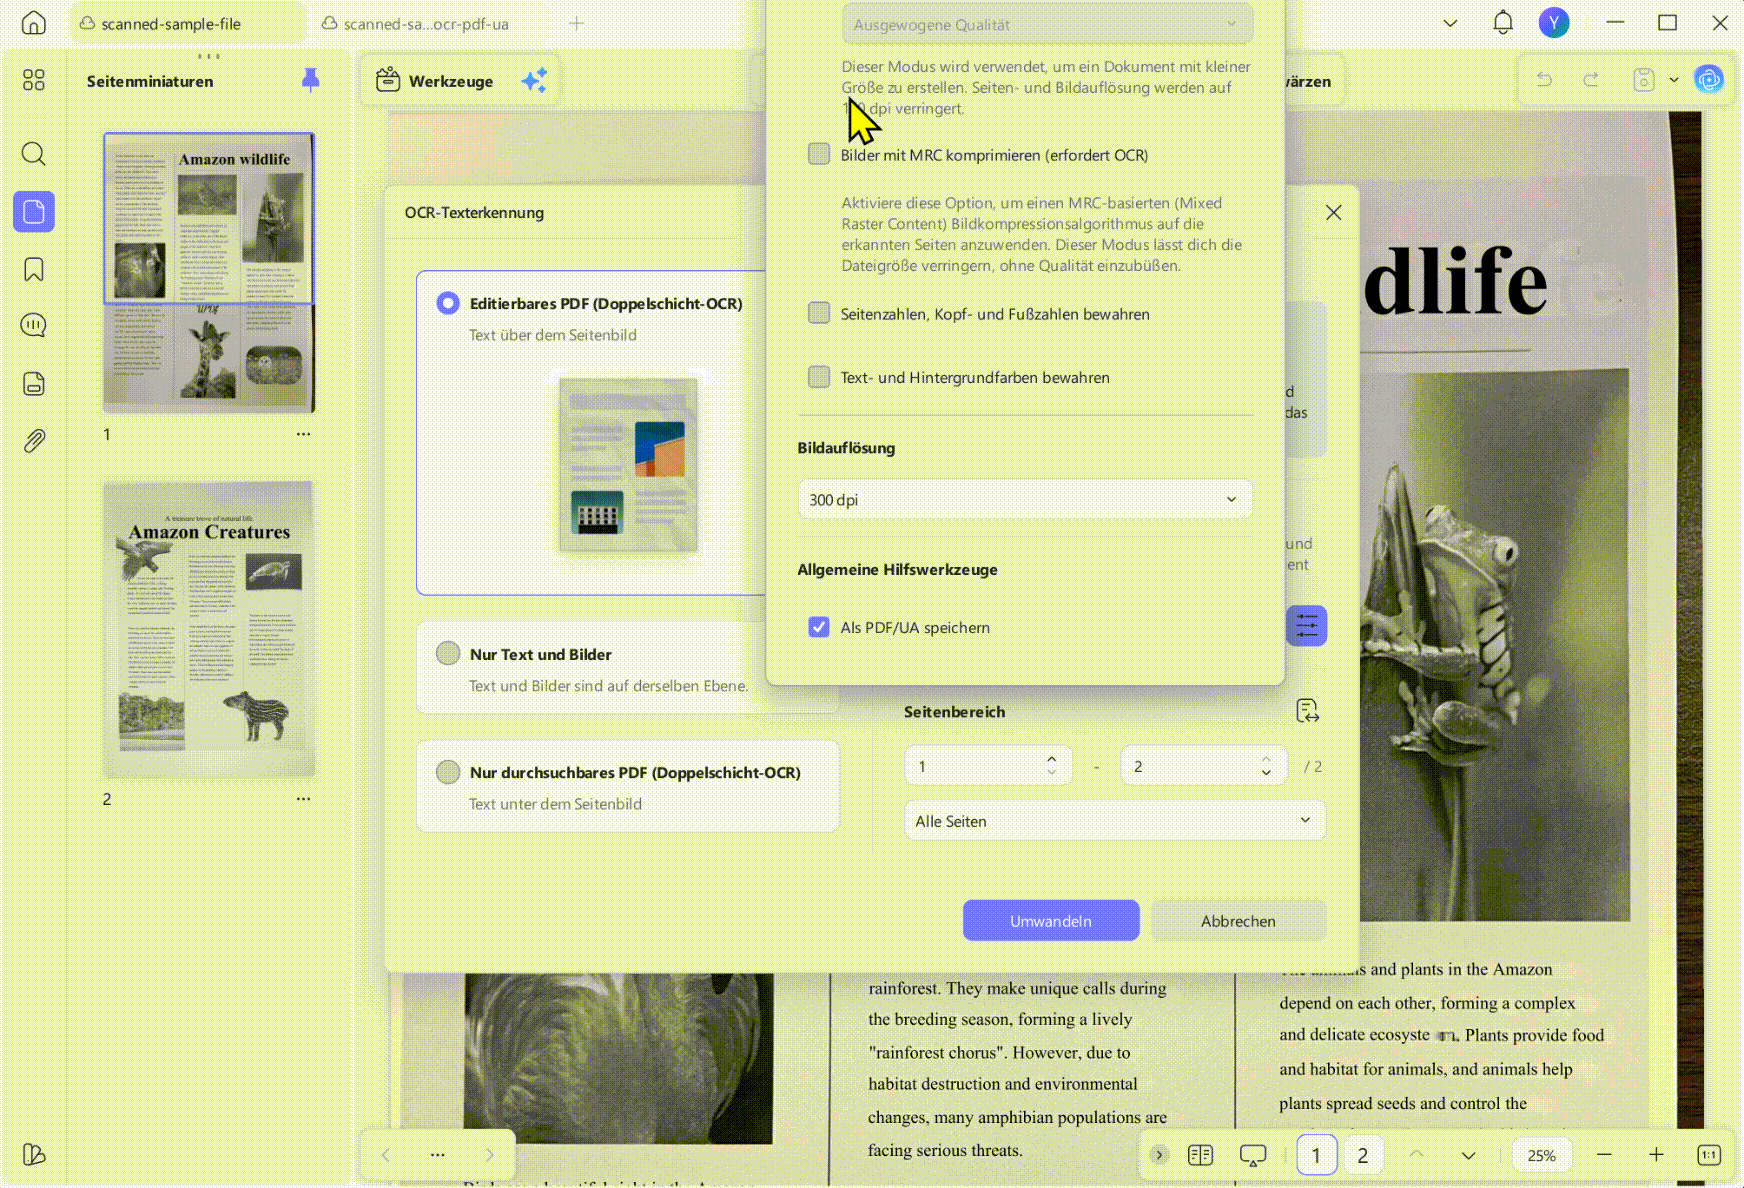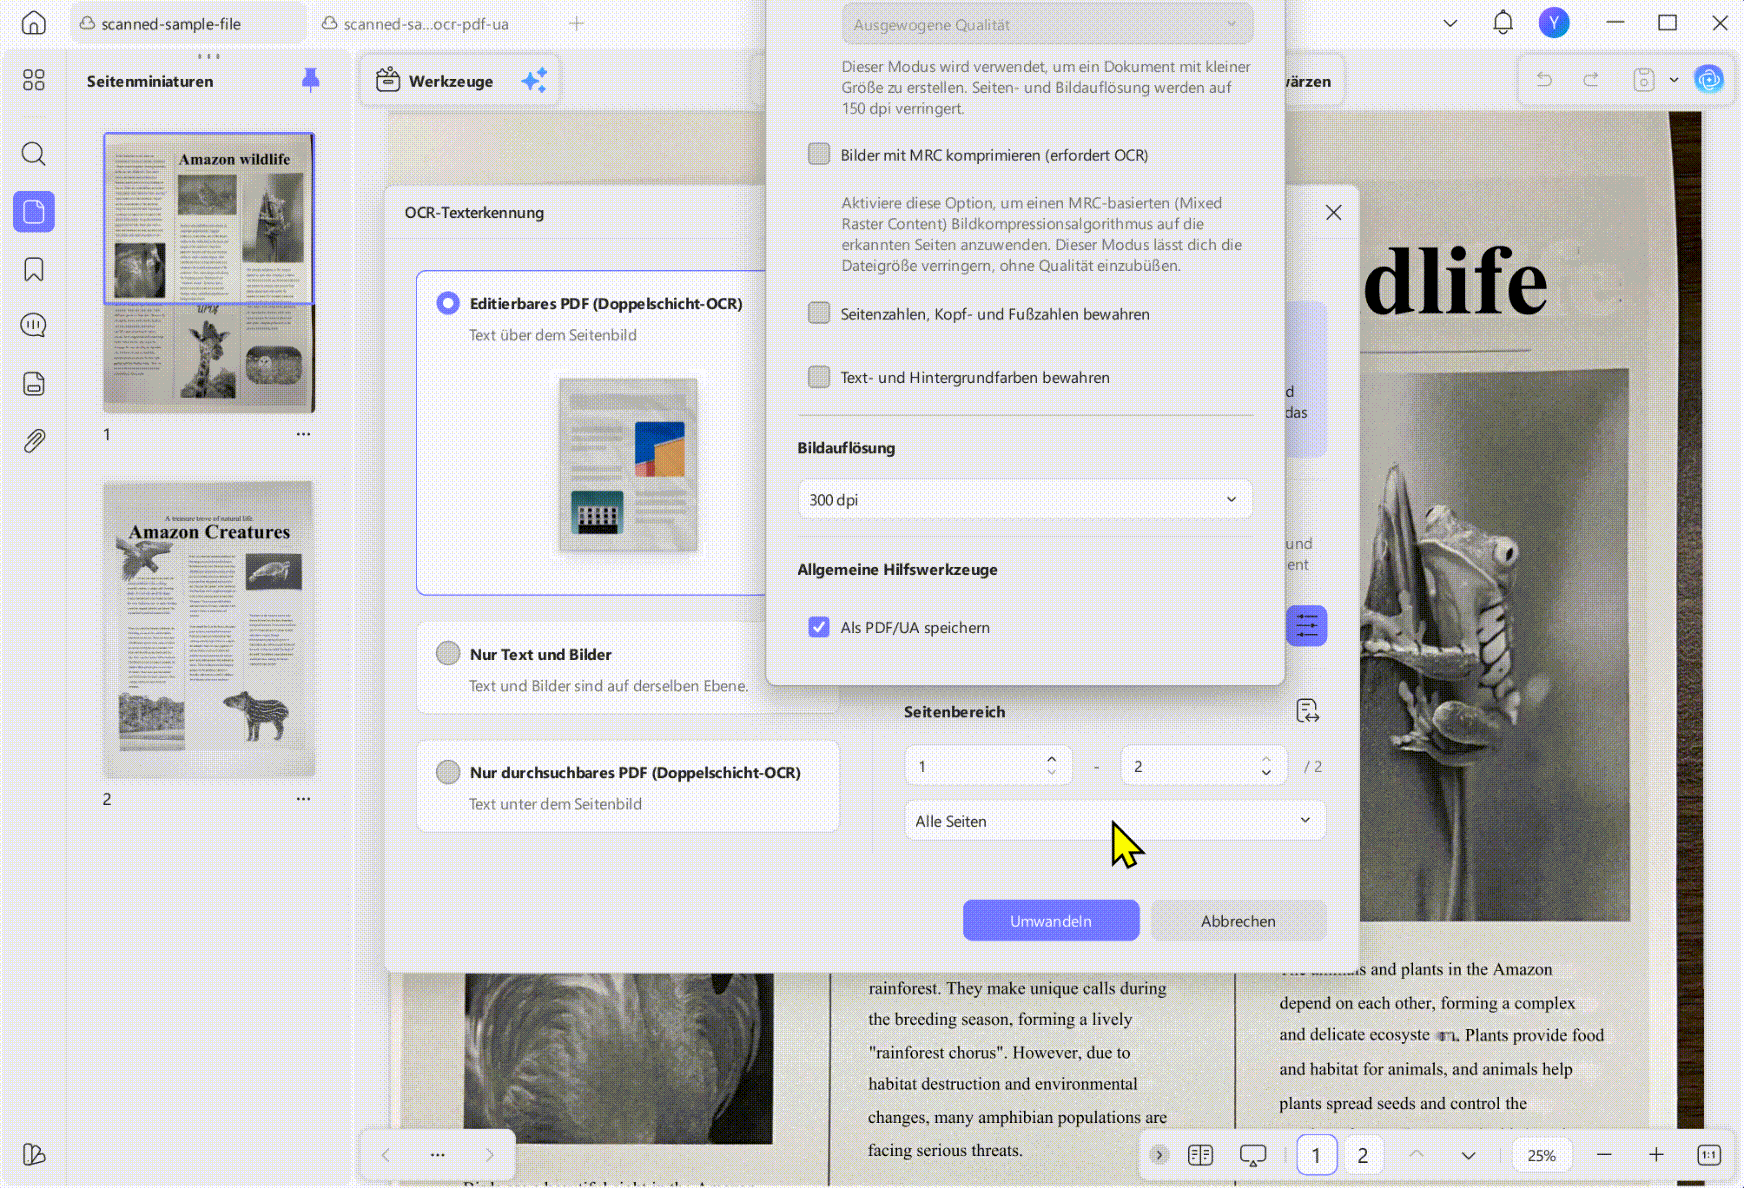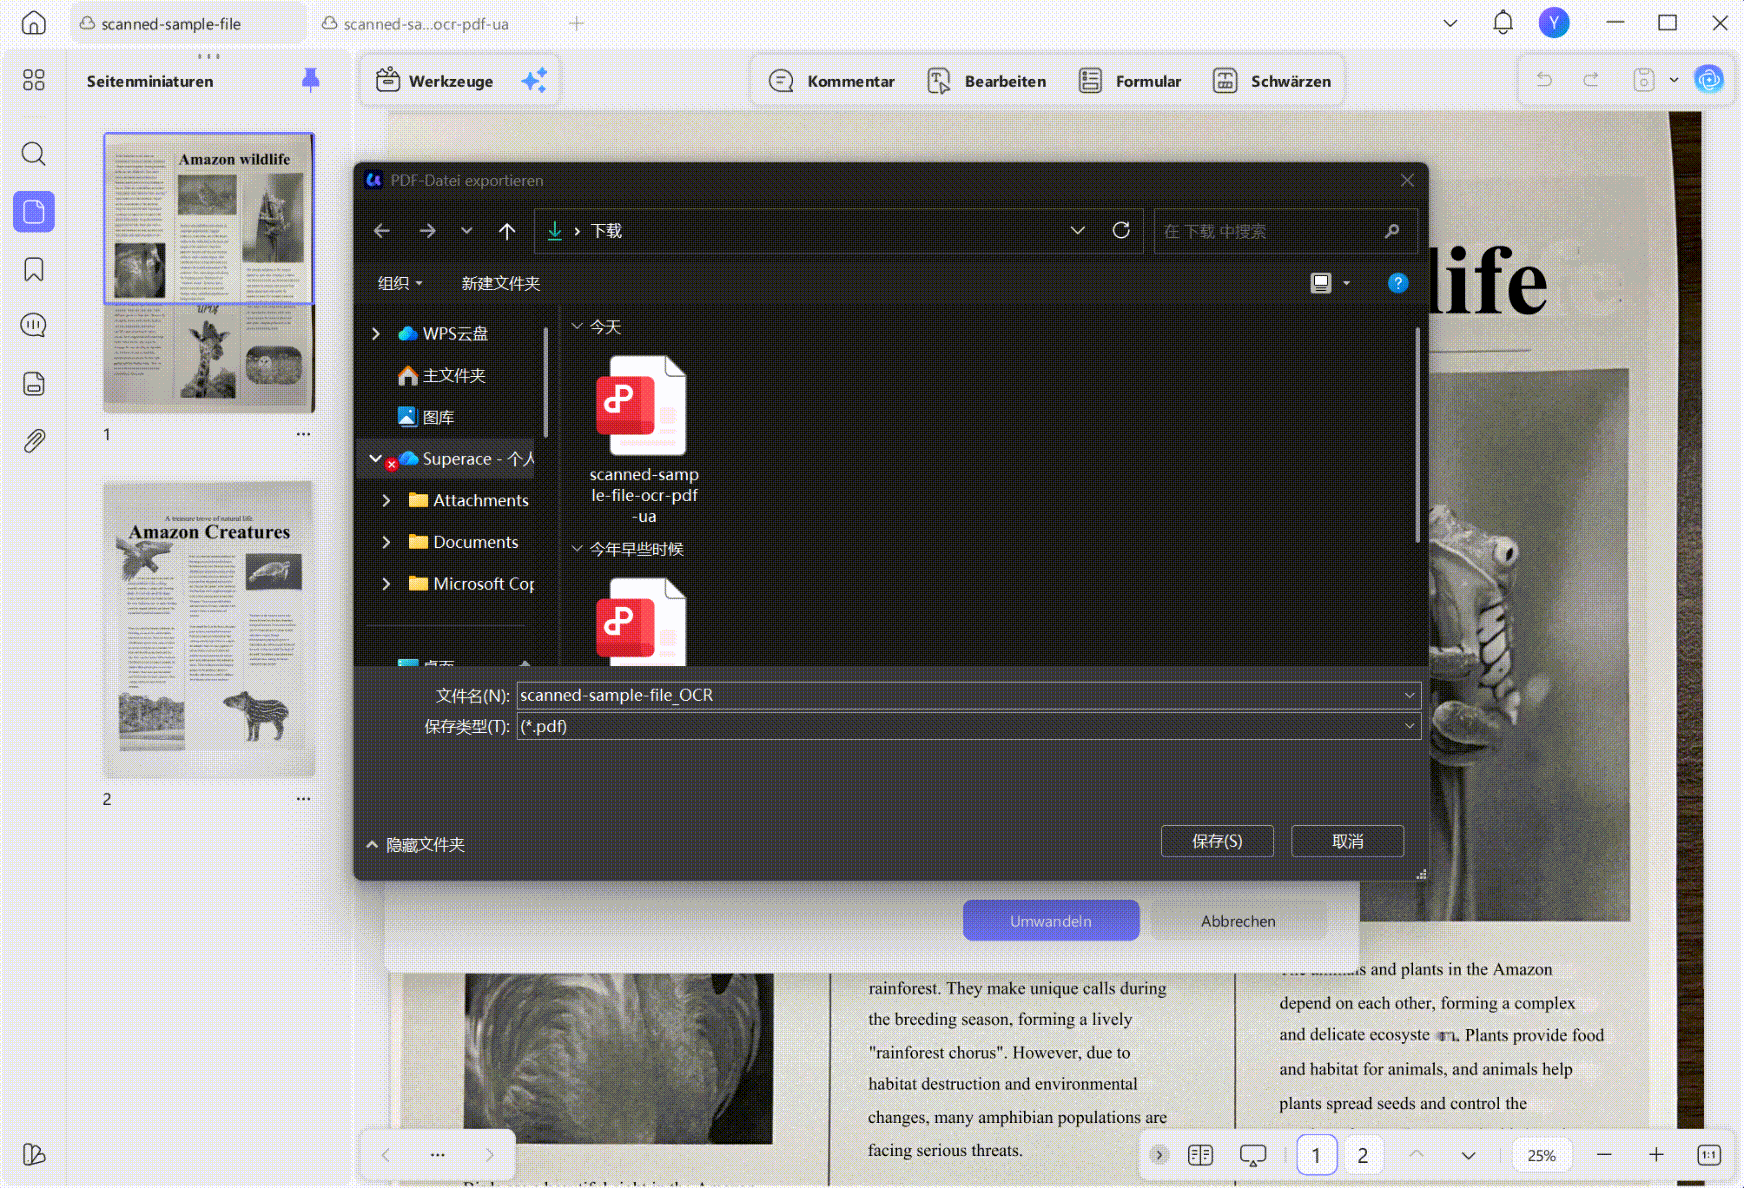
Öffnen Sie in den OCR-Einstellungen die Layout-Einstellungen. Aktivieren Sie dort unter „Allgemeine Hilfswerkzeuge“ die Option:
„Als PDF/UA speichern“
Je nach Dokument können Sie außerdem folgende Einstellungen anpassen:
- Bilder bewahren,
- Seitenzahlen sowie Kopf- und Fußzeilen bewahren,
- Text- und Hintergrundfarben bewahren,
- Bildauflösung festlegen.
Schritt 5: Datei umwandeln
Klicken Sie auf „Umwandeln“. UPDF führt die Texterkennung durch und speichert das Ergebnis als PDF/UA-Datei.
Verwenden Sie einen neuen Dateinamen, damit der Originalscan erhalten bleibt, beispielsweise: Vertrag_PDF-UA.pdf
Schritt 6: Dokumenttitel ergänzen
Der Dateiname und der interne Dokumenttitel sind zwei unterschiedliche Angaben. Screenreader und Prüfprogramme lesen den Titel aus den PDF-Metadaten und nicht aus dem Namen der Datei.
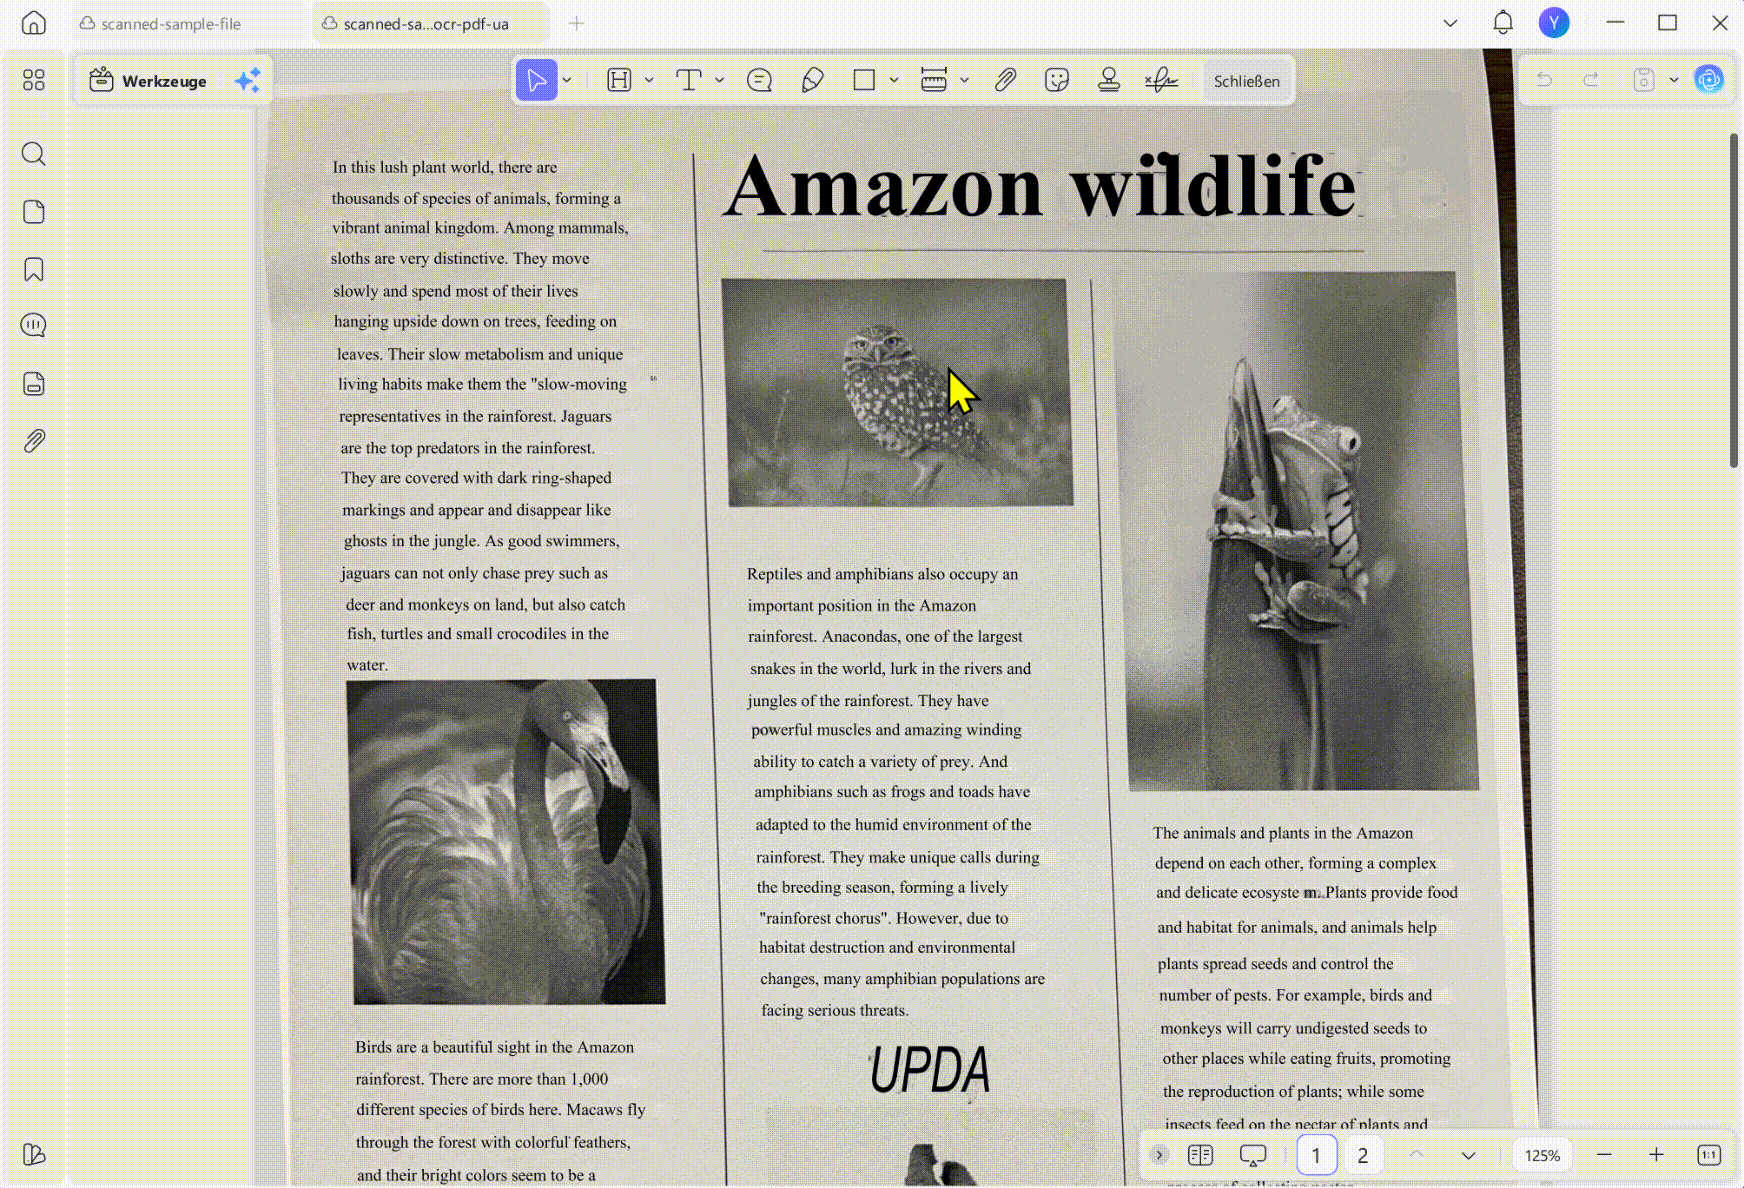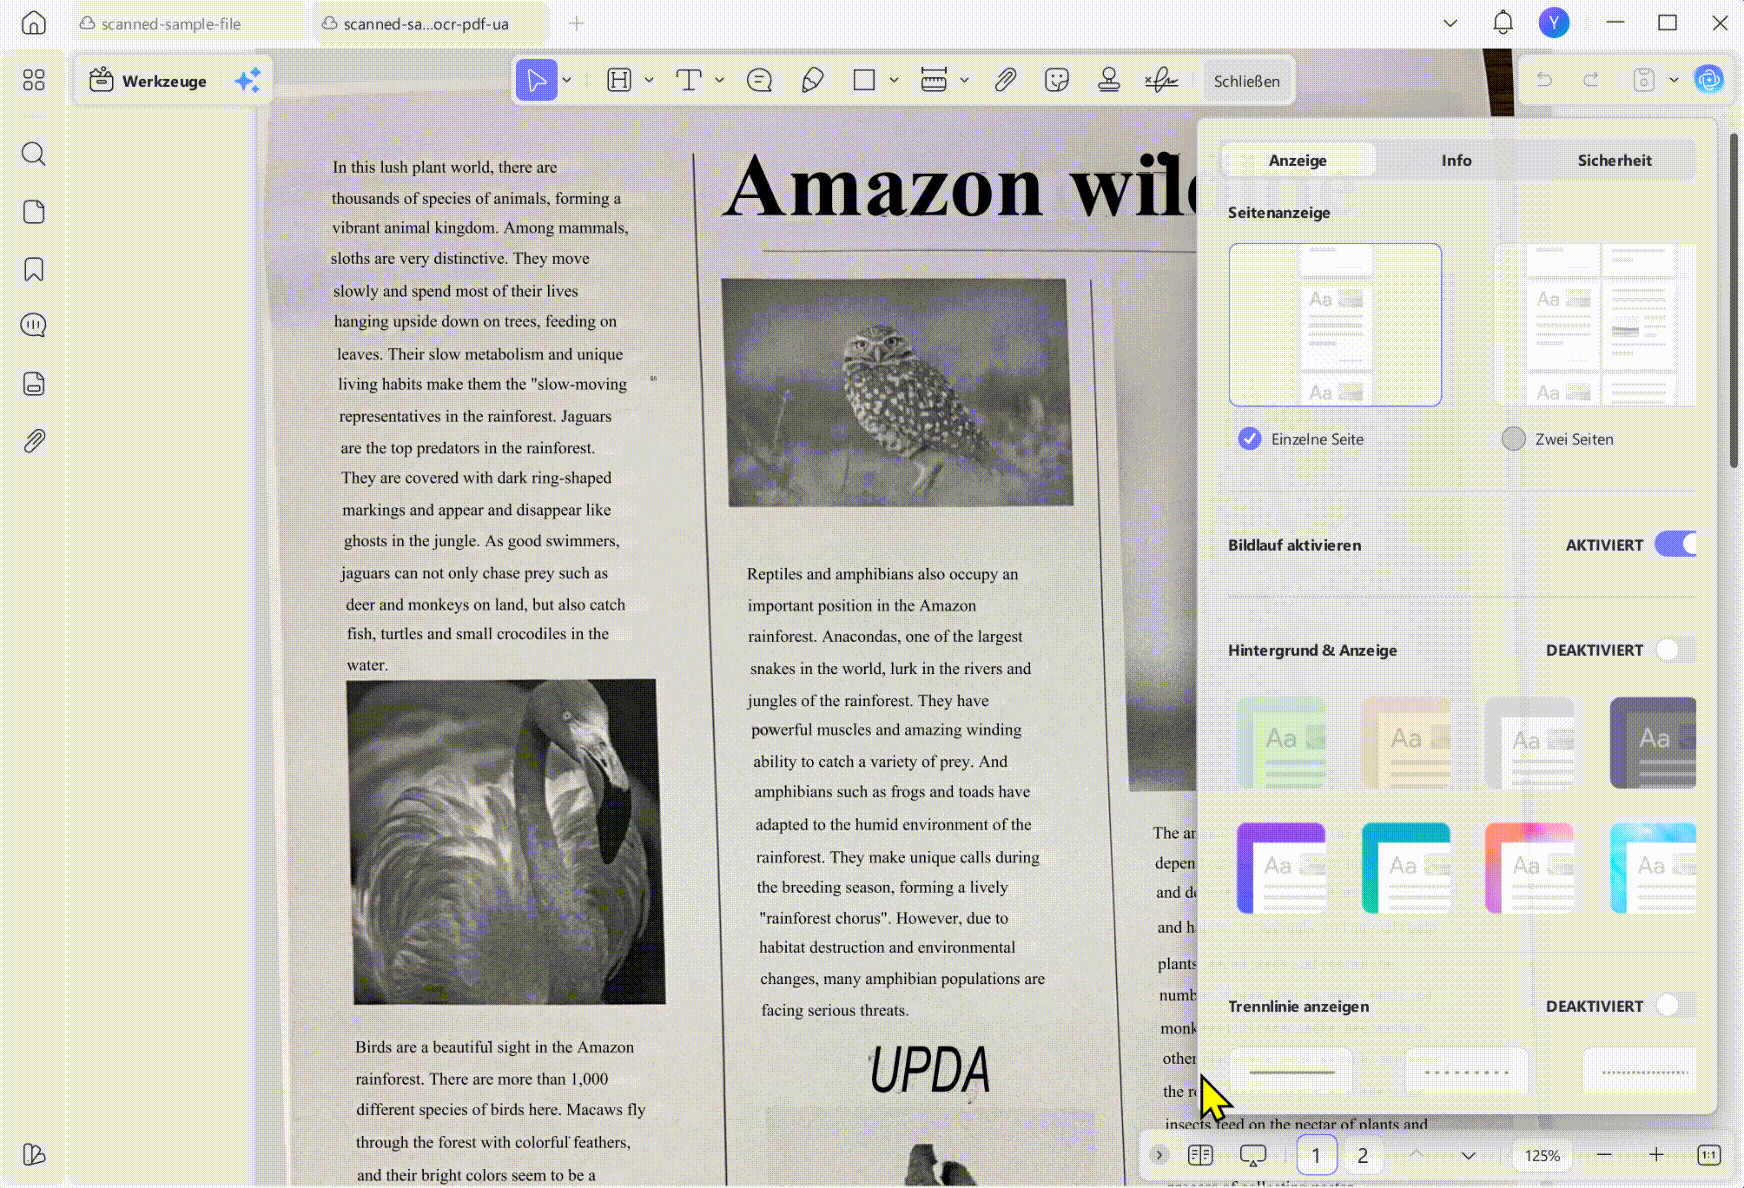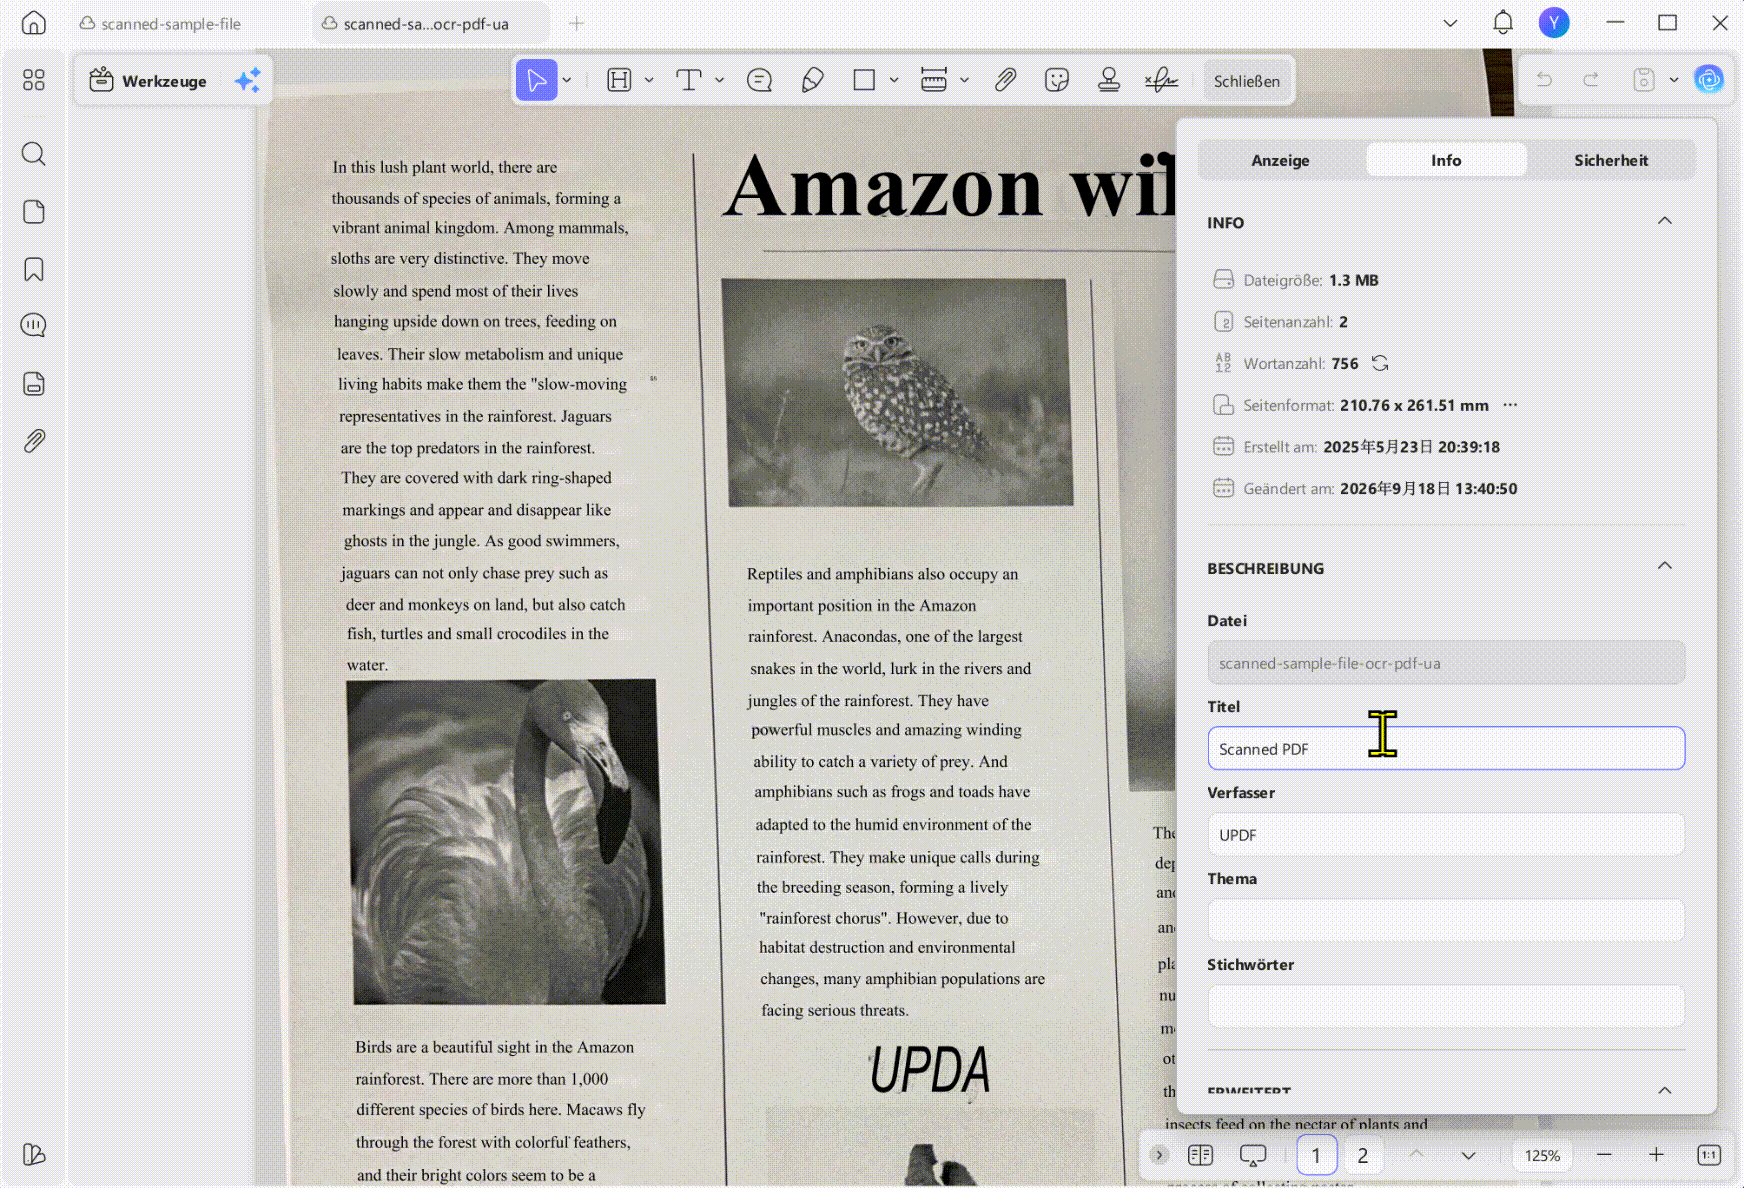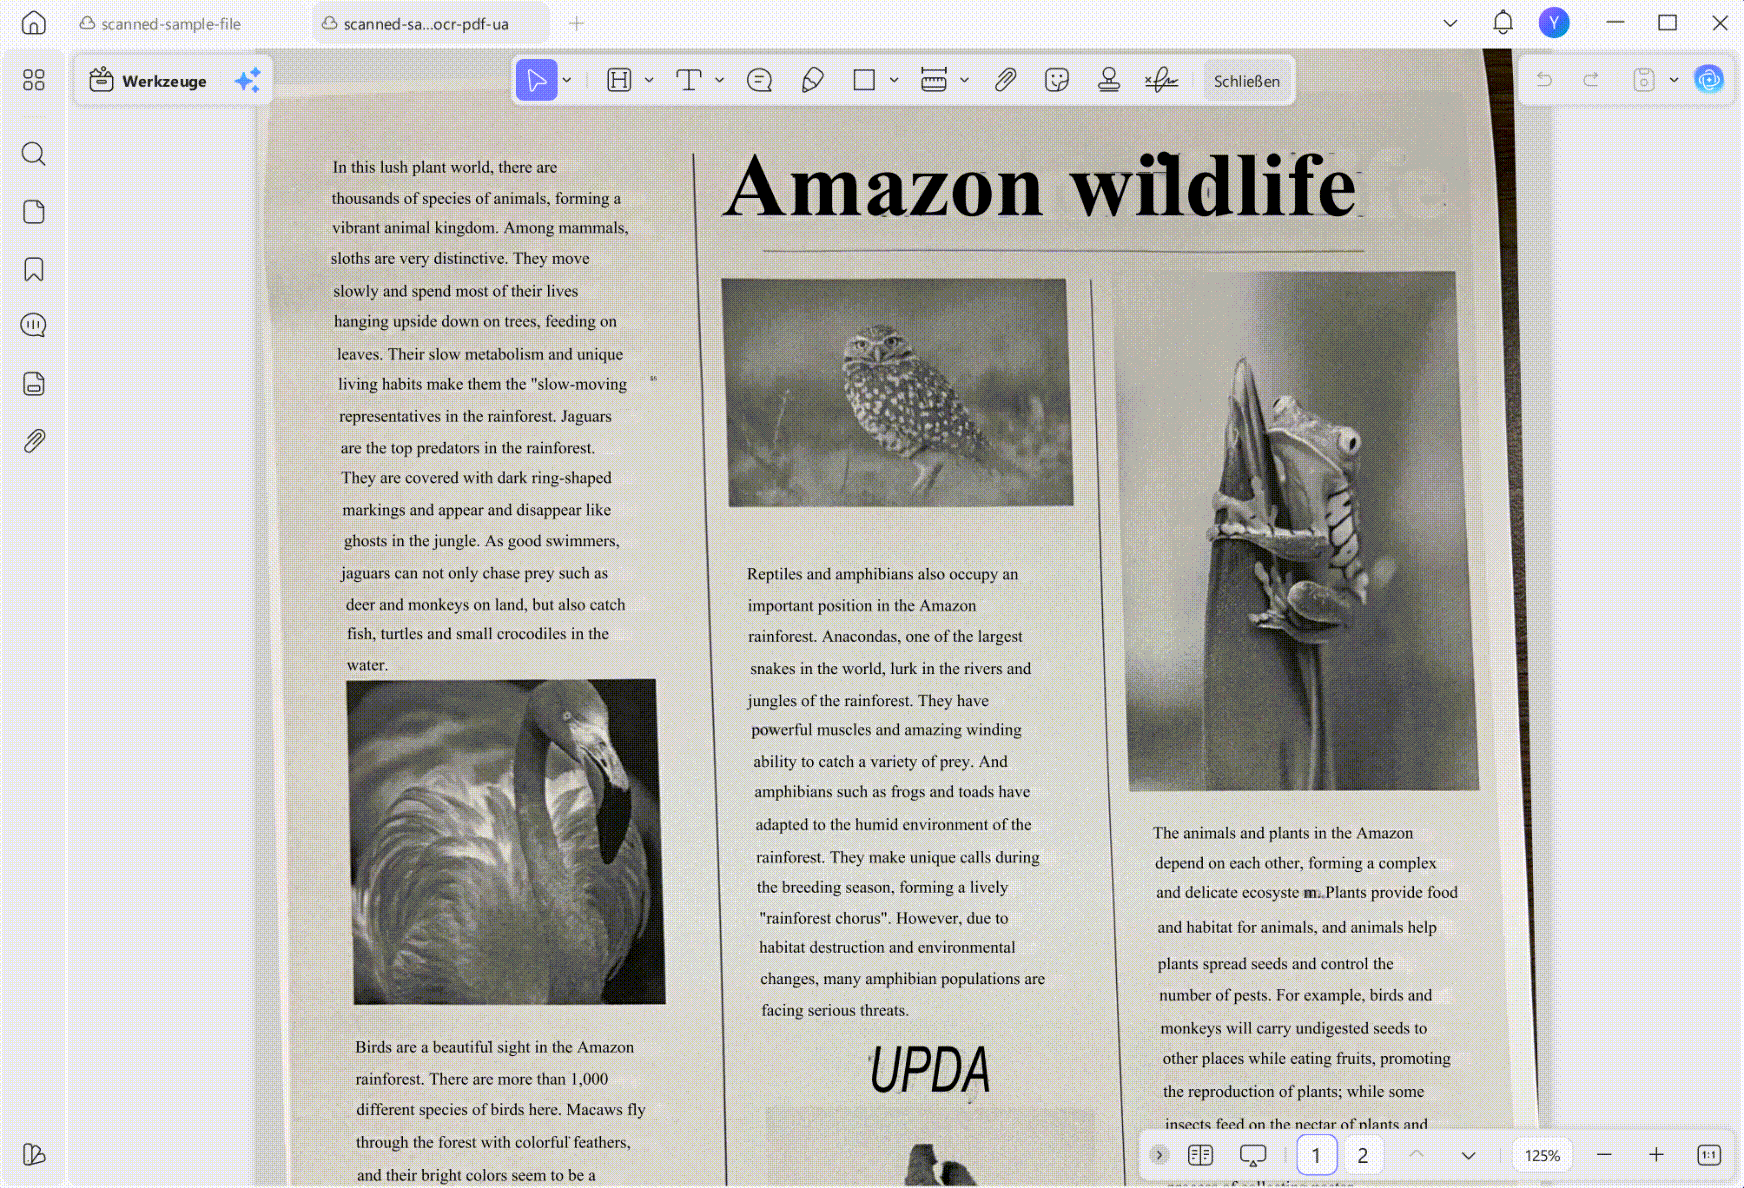
Falls PAC nach dem Export Unknown Title anzeigt, können Sie den Titel in UPDF ergänzen:
- Öffnen Sie die exportierte PDF.
- Klicken Sie mit der rechten Maustaste auf die Seite.
- Wählen Sie „Eigenschaften“.
- Öffnen Sie den Bereich „Info“.
- Tragen Sie unter „Titel“ eine aussagekräftige Bezeichnung ein.
- Speichern Sie die Datei.
Windows • macOS • iOS • Android 100% sicher
PDF/UA-Ergebnis mit PAC prüfen
Für unseren Test wurde ein zweiseitiges gescanntes Dokument mit UPDF für Windows per OCR verarbeitet und als PDF/UA ausgegeben. Die Metadaten der erzeugten Datei kennzeichneten das Dokument als PDF/UA-1.
Anschließend wurde die Datei mit dem kostenlosen PDF Accessibility Checker PAC 2026 geprüft. Die automatisch prüfbaren PDF/UA- und WCAG-Anforderungen wurden ohne Fehler abgeschlossen.
PAC erkannte unter anderem:
- 52 PDF-Tags,
- eine vorhandene Strukturhierarchie,
- Strukturelemente,
- Rollenzuordnungen,
- Alternativbeschreibungen,
- Sprachinformationen,
- Dokumentmetadaten.
Nach Ergänzung eines Dokumenttitels zeigte PAC weiterhin eine Warnung in der separaten Qualitätsprüfung, jedoch keinen Fehler in der PDF/UA- oder WCAG-Prüfung.
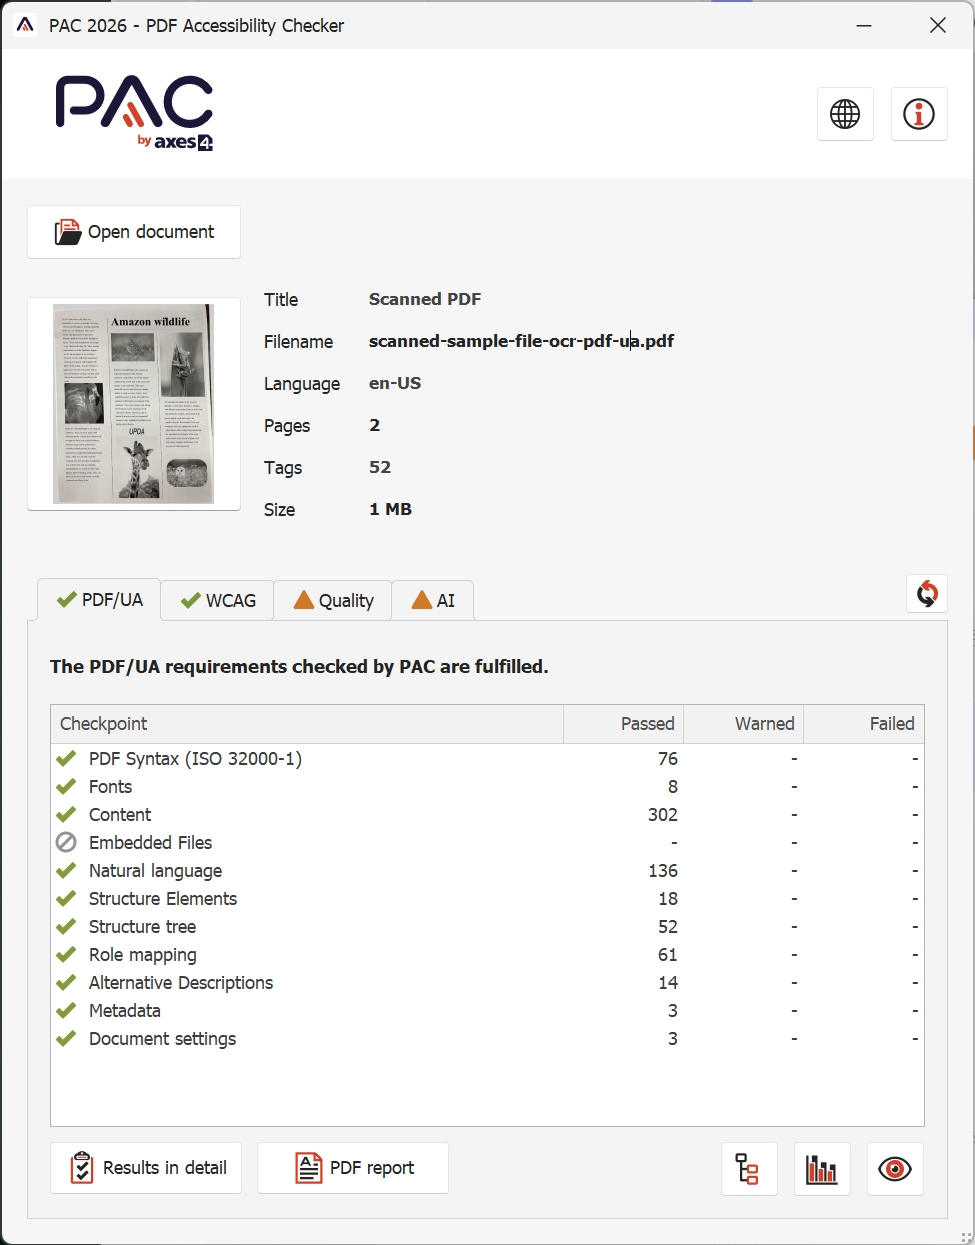
Testergebnis: Die mit UPDF erzeugte Datei erfüllte die von PAC automatisch geprüften PDF/UA- und WCAG-Anforderungen. Die separate Qualitätsprüfung zeigte weiterhin einen Hinweis. Das bestätigt die technische PDF/UA-Ausgabe, ersetzt aber keine vollständige manuelle Bewertung der praktischen Barrierefreiheit.
Was verbessert der PDF/UA-Export eines Scans?
Die Kombination aus OCR und PDF/UA-Ausgabe kann mehrere praktische Verbesserungen schaffen.
Text kann durchsucht werden
Nutzer können Namen, Aktenzeichen, Rechnungsnummern oder andere Angaben innerhalb der Datei finden.
Text kann ausgewählt werden
Erkannte Inhalte lassen sich markieren, kopieren und in anderen Anwendungen weiterverwenden.
Screenreader erhalten eine Textgrundlage
Assistive Technologien können die erkannte Textebene grundsätzlich besser verarbeiten als ein reines Seitenbild.
Inhalte lassen sich weiterbearbeiten
Abhängig vom gewählten OCR-Modus kann der erkannte Text anschließend kontrolliert und korrigiert werden.
Die Datei erhält Strukturinformationen
Der PDF/UA-Export schafft eine bessere technische Grundlage für die weitere Prüfung und Nachbearbeitung.
Diese Vorteile sind besonders bei einfachen, überwiegend textbasierten Dokumenten relevant.
Wann reicht der automatische Export nicht aus?
Auch eine durchsuchbare und technisch als PDF/UA gekennzeichnete Datei kann weiterhin Barrieren enthalten.
Mehrspaltige Seiten
Bei Broschüren und Zeitschriften kann die technische Lesereihenfolge von der sichtbaren Reihenfolge abweichen. Ein Screenreader springt dann möglicherweise zwischen den Spalten.
Komplexe Tabellen
OCR kann den Text in den Zellen erkennen, aber nicht immer die korrekte Beziehung zwischen Überschriften, Zeilen und Spalten herstellen.
Bilder und Diagramme
Die Texterkennung erzeugt nicht automatisch eine inhaltlich passende Beschreibung eines Bildes oder Diagramms.
Formulare
Formularfelder benötigen verständliche Bezeichnungen, eine logische Tastaturreihenfolge und erkennbare Hinweise zu Pflichtfeldern.
Handschrift und schlechte Bildqualität
Handschriftliche Einträge, Schatten, Falten und unscharfe Scans können deutliche Erkennungsfehler verursachen.
Technische und mathematische Inhalte
Formeln, Sonderzeichen und technische Zeichnungen benötigen häufig eine gesonderte Prüfung.
Bei solchen Dateien sollte der PDF/UA-Export als Ausgangspunkt und nicht als abgeschlossene Barrierefreiheitsprüfung verstanden werden.
PDF/UA richtig kontrollieren
Eine zuverlässige Prüfung besteht aus mehreren Ebenen.
1. Sichtprüfung
Kontrollieren Sie, ob Seiten, Bilder, Tabellen und Umbrüche vollständig dargestellt werden.
2. OCR-Prüfung
Vergleichen Sie erkannte Inhalte mit dem Originalscan. Achten Sie besonders auf:
- Namen,
- Zahlen,
- Datumsangaben,
- Währungen,
- Aktenzeichen,
- Fachbegriffe,
- Umlaute und Sonderzeichen.
3. Automatische PDF/UA-Prüfung
Ein Werkzeug wie PAC kann zahlreiche technische PDF/UA- und WCAG-Anforderungen automatisch überprüfen.
4. Struktur- und Lesereihenfolge prüfen
Nutzen Sie die Strukturansicht oder Screenreader-Vorschau des Prüfprogramms. Kontrollieren Sie, ob Überschriften, Absätze, Listen und Tabellen in einer verständlichen Reihenfolge erscheinen.
5. Manuelle Qualitätskontrolle
Automatische Prüfungen können erkennen, ob ein Alternativtext vorhanden ist. Ob dieser den Inhalt eines Bildes sinnvoll beschreibt, muss jedoch ein Mensch beurteilen.
Merksatz:
PDF/UA und rechtliche Anforderungen in Deutschland
Für öffentliche Stellen des Bundes ergeben sich Anforderungen an digitale Barrierefreiheit unter anderem aus dem Behindertengleichstellungsgesetz und der BITV 2.0.
Auch bestimmte Produkte und Dienstleistungen, die unter das Barrierefreiheitsstärkungsgesetz fallen, können barrierefreie Dokumente erfordern. Das kann beispielsweise elektronische Tickets oder Produktanleitungen im PDF-Format betreffen.
Die Bundesfachstelle Barrierefreiheit erläutert die geltenden Zusammenhänge und verweist auf die Anforderungen der EN 301 549.
Hinweis:
PDF/UA, PDF/A, PDF/X und PDF/E: Welches Format brauchen Sie?
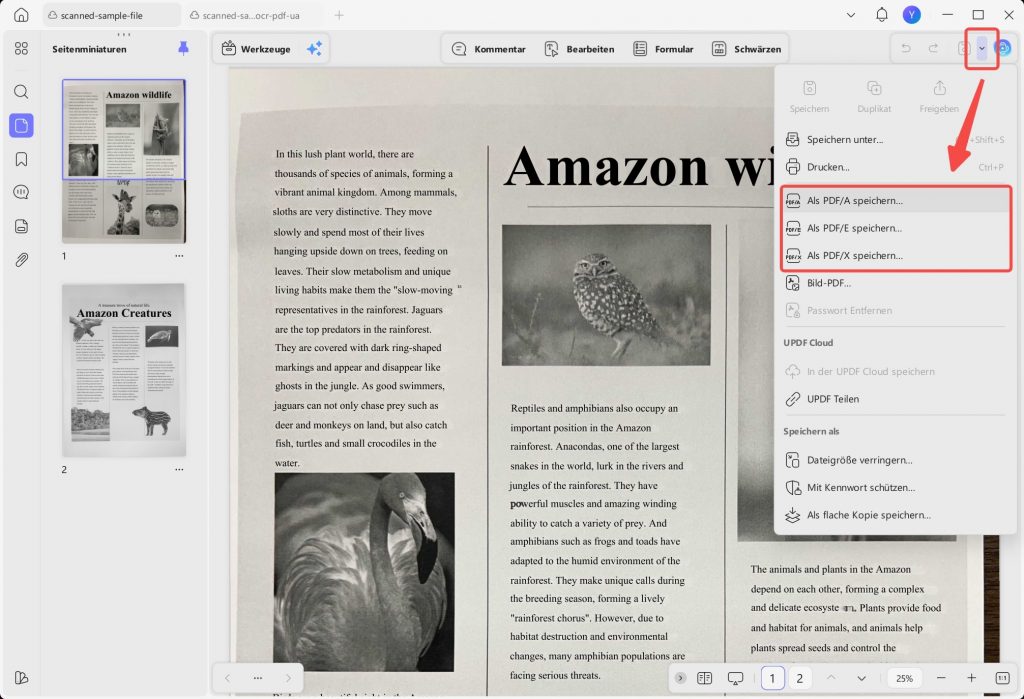
UPDF unterstützt neben der PDF/UA-Ausgabe im Windows-OCR-Workflow auch das Speichern als PDF/A, PDF/X und PDF/E. Diese Formate verfolgen unterschiedliche Ziele.
Windows • macOS • iOS • Android 100% sicher
| Format | Hauptzweck | Typische Anwendung | Unterstützung in UPDF |
|---|---|---|---|
| PDF/UA | Barrierefreie Nutzung | Zugängliche Dokumente für Screenreader und andere assistive Technologien | OCR-Ergebnisse unter Windows als PDF/UA speichern |
| PDF/A | Langzeitarchivierung | Verträge, Rechnungen, Akten und Forschungsunterlagen langfristig aufbewahren | PDF direkt als PDF/A speichern |
| PDF/X | Professioneller Druckdatenaustausch | Broschüren, Plakate und andere Druckdateien vorbereiten | PDF direkt als PDF/X speichern |
| PDF/E | Technische Dokumente | Zeichnungen, Bauunterlagen und Engineering-Dokumente austauschen | PDF direkt als PDF/E speichern |
| Standard-PDF | Allgemeine Bearbeitung und Weitergabe | Dokumente bearbeiten, kommentieren, teilen oder schützen | Normale PDF-Funktionen ohne spezielles Archivierungs- oder Austauschziel |
PDF/UA konzentriert sich auf Zugänglichkeit. PDF/A dient dagegen der langfristigen und reproduzierbaren Aufbewahrung. PDF/X ist für standardisierte Druckabläufe vorgesehen, während PDF/E technische und ingenieurbezogene Dokumente adressiert.
Eine PDF/A-Datei ist nicht automatisch barrierefrei. Ebenso erfüllt eine PDF/UA-Datei nicht automatisch jede Archivierungsanforderung.
Entscheidungshilfe:
Häufige Fehler beim Umgang mit PDF/UA
PDF/UA nur als Dateiformat betrachten
PDF/UA besitzt keine eigene Dateiendung. Die Datei endet weiterhin auf .pdf. Entscheidend sind die enthaltenen Strukturinformationen und deren korrekte Verwendung.
OCR mit vollständiger Barrierefreiheit gleichsetzen
OCR macht Bildtext maschinenlesbar. Sie erzeugt nicht automatisch eine perfekte Lesereihenfolge, hochwertige Alternativtexte oder vollständige Tabellenstrukturen.
Nur die grüne PDF/UA-Anzeige betrachten
Eine bestandene automatische Prüfung ist wichtig, deckt aber nicht jede qualitative oder inhaltliche Anforderung ab. Beachten Sie auch Warnungen und die separate Qualitätsprüfung.
Das Ausgangsdokument ignorieren
Wenn die Quelldatei noch vorhanden und bereits gut strukturiert ist, sollte möglichst von dieser Datei aus gearbeitet werden. Eine nachträgliche Reparatur im PDF ist häufig aufwendiger.
Plattformunterschiede übersehen
Die PDF/UA-Ausgabe innerhalb der OCR-Funktion steht aktuell nur in UPDF für Windows zur Verfügung.
FAQ zu PDF/UA
Kann ich jede gescannte PDF in PDF/UA umwandeln?
Eine gescannte PDF kann per OCR erkannt und anschließend als PDF/UA ausgegeben werden. Bei einfachen Textdokumenten liefert dieser Arbeitsablauf eine gute technische Grundlage. Komplexe Tabellen, Formulare, Bilder und mehrspaltige Seiten benötigen häufig zusätzliche Nachbearbeitung.
Kann UPDF eine gescannte Datei als PDF/UA speichern?
UPDF für Windows kann OCR-Ergebnisse als PDF/UA speichern. Öffnen Sie dazu die gescannte Datei, starten Sie die OCR-Texterkennung und aktivieren Sie in den Layout-Einstellungen die Option „Als PDF/UA speichern“.
Ist die PDF/UA-Funktion auch auf dem Mac verfügbar?
Die PDF/UA-Ausgabe innerhalb der OCR-Funktion ist derzeit nur in UPDF für Windows verfügbar. UPDF für Mac, iOS und Android bietet diese Option aktuell nicht an.
Erstellt UPDF PDF/UA-1 oder PDF/UA-2?
Die von uns mit UPDF für Windows getestete Datei wurde in den Metadaten als PDF/UA-1 gekennzeichnet. Da sich die unterstützte Ausgabe mit späteren Versionen ändern kann, sollte sie bei wichtigen Dokumenten erneut geprüft werden.
Bedeutet eine bestandene PAC-Prüfung, dass die PDF vollständig barrierefrei ist?
Eine bestandene automatische PAC-Prüfung bestätigt die maschinell kontrollierbaren Anforderungen. Lesereihenfolge, Qualität der Alternativtexte, inhaltliche Verständlichkeit und komplexe Strukturen müssen zusätzlich manuell beurteilt werden.
Ist PDF/A dasselbe wie PDF/UA?
PDF/A und PDF/UA verfolgen unterschiedliche Ziele. PDF/A ist für die Langzeitarchivierung vorgesehen, während PDF/UA die Zugänglichkeit für assistive Technologien unterstützt.
Fazit
PDF/UA ist besonders relevant, wenn PDF-Dokumente nicht nur visuell dargestellt, sondern auch durchsucht, vorgelesen und mit assistiven Technologien genutzt werden sollen.
Bei gescannten Dokumenten beginnt dieser Weg mit einer zuverlässigen OCR-Texterkennung. UPDF für Windows kann den erkannten Inhalt anschließend als PDF/UA speichern. In unserem Test erfüllte die erzeugte PDF/UA-1-Datei die automatisch prüfbaren PDF/UA- und WCAG-Anforderungen in PAC 2026.
Der erfolgreiche Export ersetzt jedoch keine vollständige Qualitätskontrolle. Prüfen Sie OCR-Fehler, Lesereihenfolge, Dokumenttitel, Alternativbeschreibungen und komplexe Strukturen. Bei amtlichen, veröffentlichten oder rechtlich relevanten Dokumenten sollte das Ergebnis zusätzlich fachlich bewertet werden.
Möchten Sie einen eigenen Scan testen? Laden Sie UPDF für Windows herunter, führen Sie die OCR-Texterkennung aus und aktivieren Sie anschließend „Als PDF/UA speichern“.
Windows • macOS • iOS • Android 100% sicher
Wenn Sie UPDF regelmäßig für OCR, PDF-Bearbeitung und spezielle Ausgabeformate einsetzen möchten, finden Sie auf der Seite zu den UPDF-Abonnements und Preisen eine Übersicht der verfügbaren Optionen.





 Wayne Austin