 UPDF
 Windows版UPDF
 Mac版UPDF
 iPhone/iPad版UPDF
 Android版UPDF
 Nomostar
 UPDF AI オンライン
 UPDF Sign
 IvyCraft
 PDF編集
 PDF注釈付け
 PDF作成
 PDFフォーム
 リンクの編集
 PDF変換
 OCR機能
 PDFからWordへ
 PDFから画像へ
 PDFからExcelへ
 PDFのページ整理
 PDF結合
 PDF分割
 ページのトリミング
 ページの回転
 PDF保護
 PDF署名
 PDFの墨消し
 PDFサニタイズ
 セキュリティ解除
 PDF閲覧
 UPDF クラウド
 PDF圧縮
 PDF印刷
 PDFのバッチ処理
 UPDF AIについて
 UPDF AIソリューション
 AIユーザーガイド
 UPDF AIによくある質問
 PDF要約
 PDF翻訳
 PDF付きチャット
 AIでチャット
 画像付きチャット
 PDFからマインドマップへの変換
 PDF説明
 PDF AIツール
 画像AIツール
 AIチャットツール
 AIライティングツール
 AI学習ツール
 AI業務ツール
 その他のAIツール
 AI ブックマーク生成
 AI ブックマーク要約
 AI 透かし生成
 AI 背景生成
 AI ステッカー生成
 AI スタンプ生成
 AI 編集スイート
 UPDF コパイロット
 AI ページ管理
 AI セマンティックサーチ
 PDFからWordへ
 PDFからExcelへ
 PDFからPowerPointへ
 ソリューション
 電子署名
 ビジネスAI
 料金プラン
 導入・運用ガイド
 ウェビナー
 IT
 教育
 建設
 金融サービス
 医療
 保険
 法務
 製造業
 官公庁
 研究者・博士向け
 個人事業主・フリーランス向け
 弁護士・法務専門家向け
 不動産担当者・仲介業者向け
 教育機関向けソリューション
 導入事例
 ユーザーガイド
 公式ブログ
 UPDF 活用術
 UPDF vs Adobe Acrobat
 UPDF vs Foxit
 UPDF vs PDF Expert
 よくある質問(FAQ)
 ダウンロードセンター
 動作環境・仕様
 お問い合わせ
 ニュースルーム
 アップデート履歴
 ユーザーレビュー
 会社概要
PDFの文字をコピーできないときは、まず「文字を選択できない」「選択できてもコピーできない」「貼り付けると文字化けする」のどれに当てはまるかを確認しましょう。画像だけのPDFにはOCR、コピーが禁止されたPDFには権限の確認、貼り付け後の文字化けには文字情報の点検が必要です。
以下の表で症状を確認し、該当する対処へ進んでください。具体的な操作はWindows版UPDFで説明します。まず短い文章のコピーを試し、必要な場合だけ権限の変更やOCRへ進みましょう。
PDFの文字をコピーできない原因を症状から確認する
当てはまる症状が分からない場合は、次の「選択方法と閲覧環境の見直し」から試してください。
| 症状 | 考えられる原因 | 最初に試す対処 |
|---|---|---|
| ドラッグするとページ全体が動く | ページ移動用のモードになっている | 文字を選択するモードに切り替える |
| 文字を選べるのにコピーできず、以前の内容が貼り付く | コピー制限、またはコピー処理が完了していない可能性がある | 作成者にコピーの許可と利用可能なファイルを確認する |
| コピーは許可されているのに文字を選べない | スキャンなどでページが画像になっており、文字情報がない可能性がある | 元データを確認し、画像だけのPDFならOCRを使う |
| 選択できるが、貼り付けると文字が化ける・抜ける | 文字情報と表示される文字の対応やOCR結果に問題がある | 別の貼り付け先で確認し、元データからの再出力も検討する |
| コピーしたはずなのに貼り付け先が空白になる | コピー処理、貼り付け先、PDFの文字情報のいずれかに問題がある | メモ帳への貼り付けと、別の文章のコピーを試して切り分ける |
| 特定のブラウザーやアプリでだけ失敗する | 表示環境やアプリ側の処理に問題がある | 保存した同じPDFを別の閲覧アプリで開いて比較する |
文字を選択できないだけで「コピー禁止」とは断定できません。PDFを開けても、コピーは制限されている場合があります。
まず試したい、選択方法と閲覧環境の見直し
通常の文字データを持つPDFなら、文字をコピーするためだけに編集モードへ切り替える必要はありません。まずは、ファイルを変えずに確認できることから試します。
選択ツール・貼り付け先・閲覧アプリを確認する
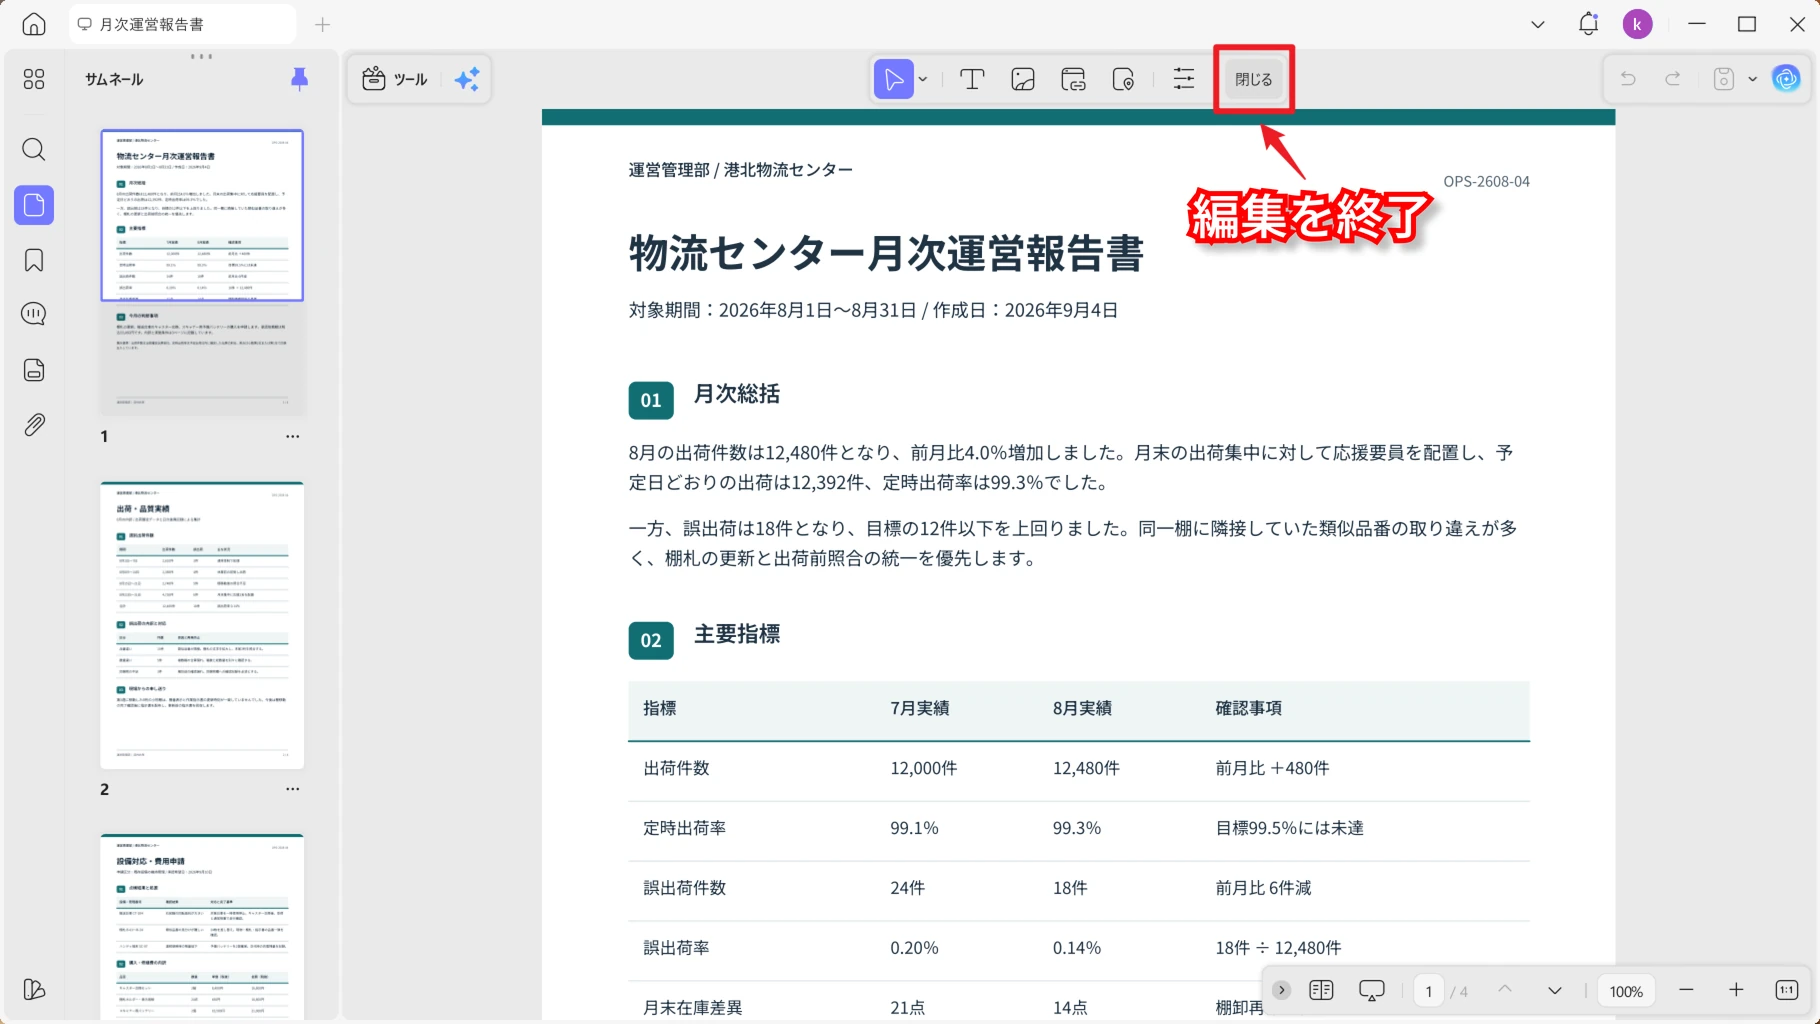
- 選択モード:UPDFで編集モードになっている場合は、上部の「閉じる」で編集を終了し、本文をドラッグします。画像全体が選ばれたり動いたりする場合も、まず閲覧状態に戻してから試してください。
- 短い文字列:一文だけを選び、WindowsではCtrl+Cでコピーし、Ctrl+Vで貼り付けます。MacではCommand+C/Command+Vを使います。
- 貼り付け先:メモ帳などに貼り付け、文字だけの状態で確認します。ここで正しく読めるなら、元の貼り付け先の書式設定を見直してください。改行や段組みの崩れは、文字そのものの誤りとは分けて対処します。
- 閲覧アプリ:メールのプレビューやブラウザー内で失敗する場合は、PDFを端末に保存して別のPDF閲覧アプリで開きます。別のアプリでは成功するなら、元の閲覧環境を更新・再起動して確認します。
貼り付けても空白になる場合は、別の文章で切り分ける
同じ文字をメモ帳へ貼り付け、そこで読めるか確認します。メモ帳でも空白なら、別の文書の短い文章をコピーして比べてください。別の文章も貼り付けられない場合は、アプリの再起動など、コピー・貼り付け機能自体の確認を優先します。
このPDFだけで起きる場合は、以下の権限と文字情報の確認へ進みます。以前コピーした文章がそのまま貼り付く場合は、新しい内容をコピーできていない可能性があります。一方、数字だけが残り日本語が抜ける場合は、文字情報に問題がある可能性があるため、「文字化け・文字抜け」の対処も確認してください。
普段Adobe Acrobat Readerを使っている方は、公式のコピー手順も確認できます。解決しない場合や別のツールを試したい場合は、以下のUPDFでの対処を参考にしてください。
Windows • macOS • iOS • Android 100%安全
基本の確認で直らないときは、原因別に対処する
ここからは、コピー権限・文字データの有無・貼り付け結果に応じて対処を選びます。該当する項目から確認してください。
コピーが禁止されている場合は、文書の権限を確認する
作成者がコピーを制限したPDFは、開いて文字を選択できても、コピーできないことがあります。開くためのパスワードと、コピーなどの制限を変更する権限パスワードは別です。開くときにパスワードを求められても、開いた後はコピーできるPDFもあります。
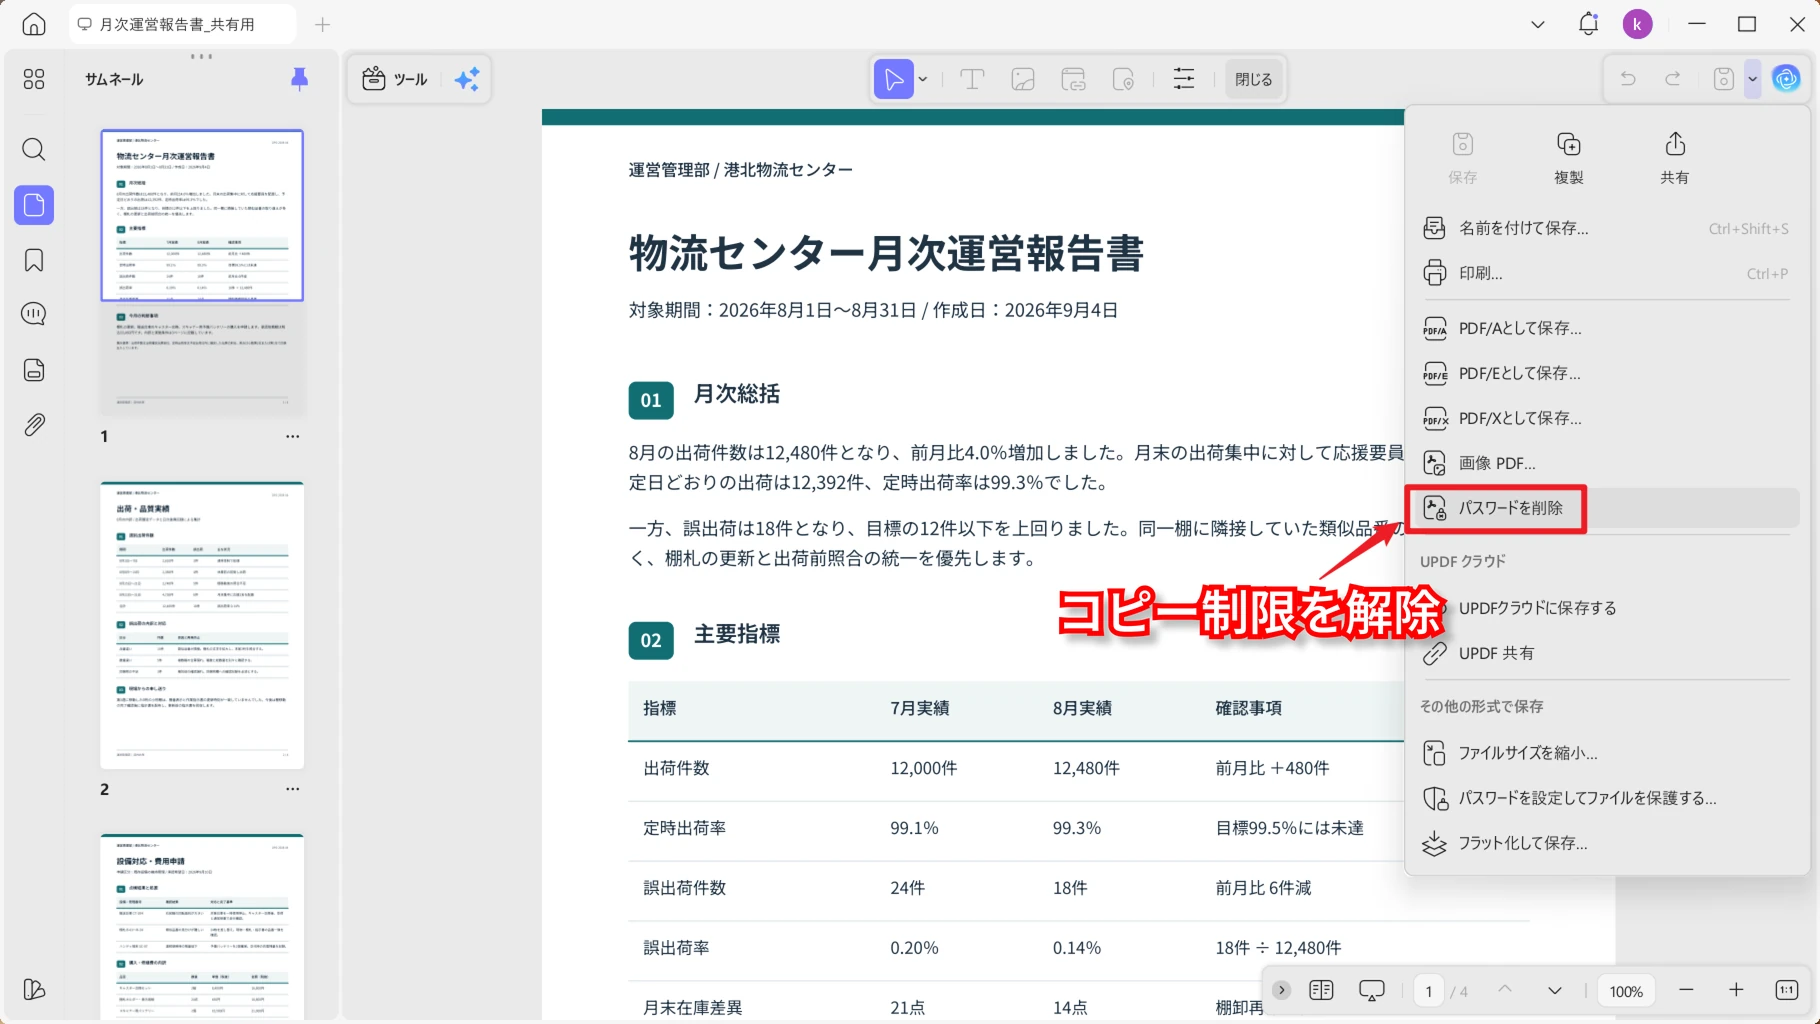
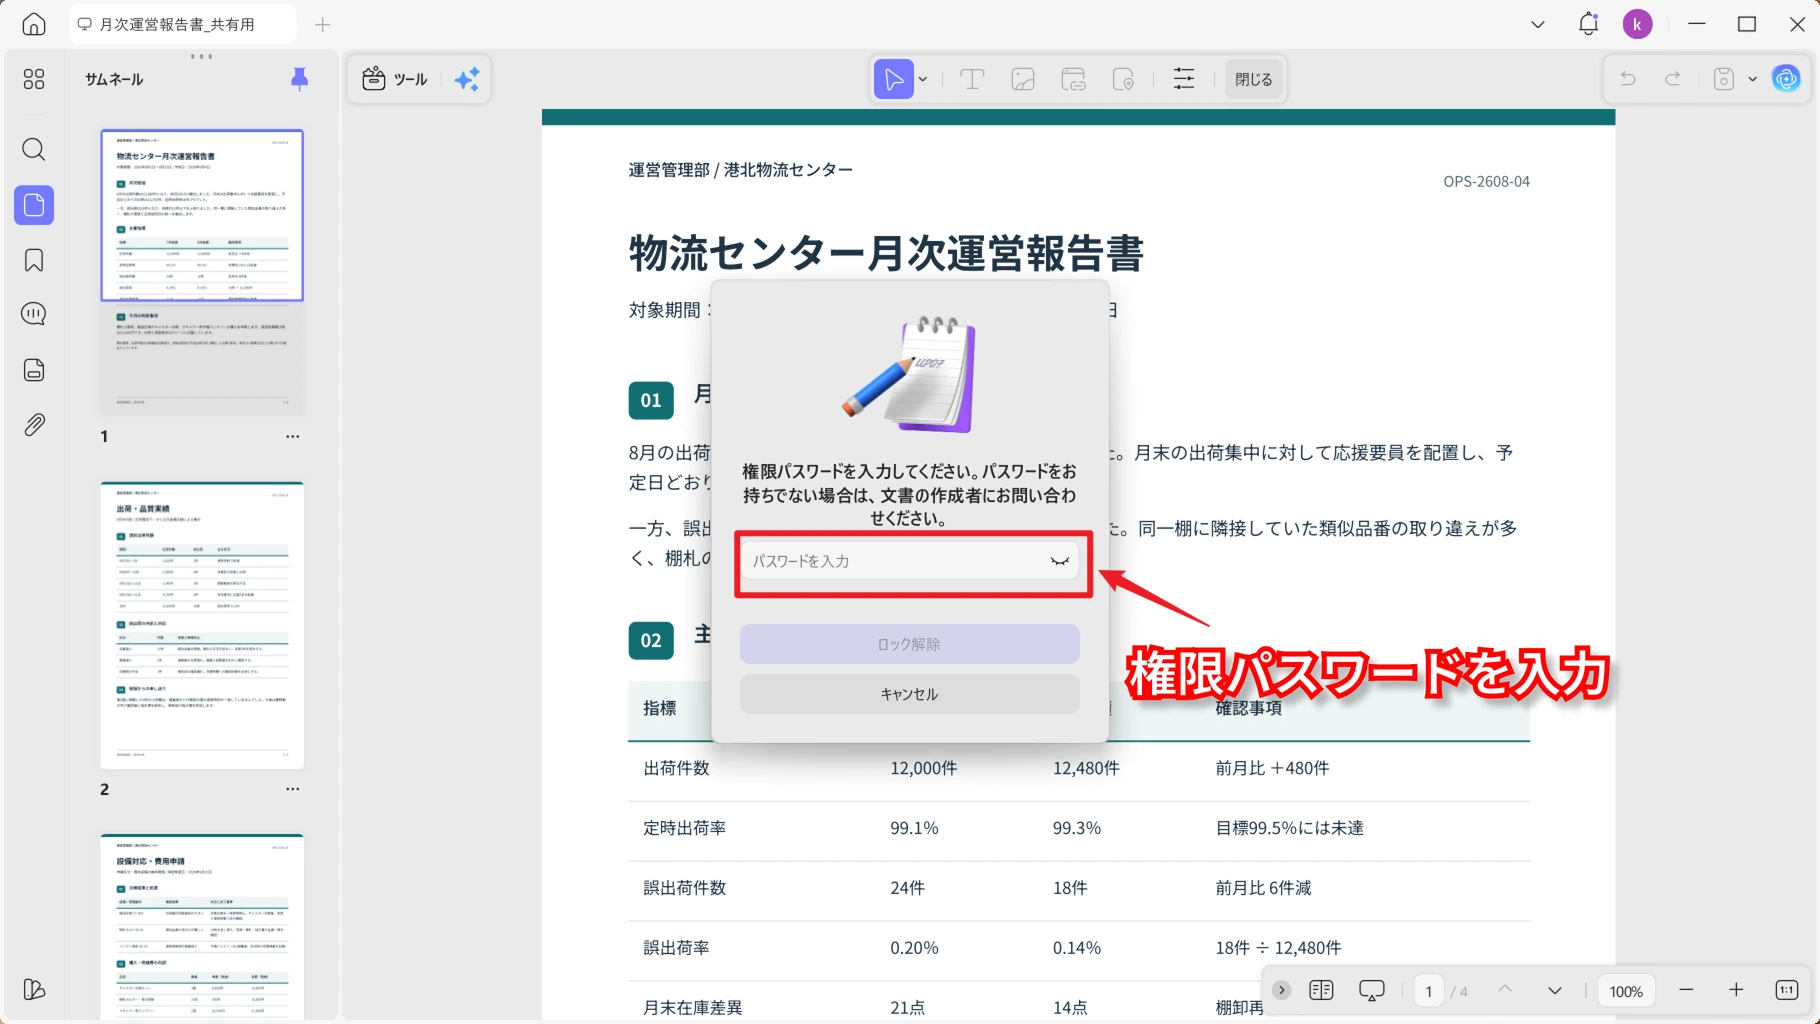
コピーの制限を変更する許可があり、権限パスワードが分かる場合は、UPDFで次の操作を行います。パスワードが不明な場合は、作成者や管理者にコピー可能なPDFや元の文書を依頼してください。
- 右上の保存ボタン横の矢印を開き、「パスワードを削除」を選びます。
- 権限パスワードを入力し、「ロック解除」をクリックします。
- 別名で保存し、保存したPDFを開いて短い文章をコピーします。
パスワードの設定・解除については、セキュリティ設定ガイドをご覧ください。
- 利用許可:保護された文書は、作成者や管理者の許可の範囲で扱います。OCRや別形式への変換は、コピーの許可を得る代わりにはなりません。
スキャンPDFは日本語OCRでコピーできる状態にする
紙の資料をスキャンしたPDFは、文字が読めても、ページの中身が画像だけの場合があります。この場合はOCR(光学文字認識)で文字情報を追加します。
元の紙面の見た目を保ちながら文字を検索・コピーしたい場合は、「検索可能なPDFのみ」を選びます。ページ画像を残し、その下に認識した文字情報を追加する方式です。認識した文章をPDF上で修正したい場合は「編集可能なPDF」を選びます。コピーが目的なら、まず検索可能なPDFで十分です。
- 無料トライアルについて:OCRによる文字認識は無料でお試しいただけます。認識後のPDFを保存・コピー・編集するには、UPDF Proが必要です。OCRの詳しい使い方はこちらをご覧ください。
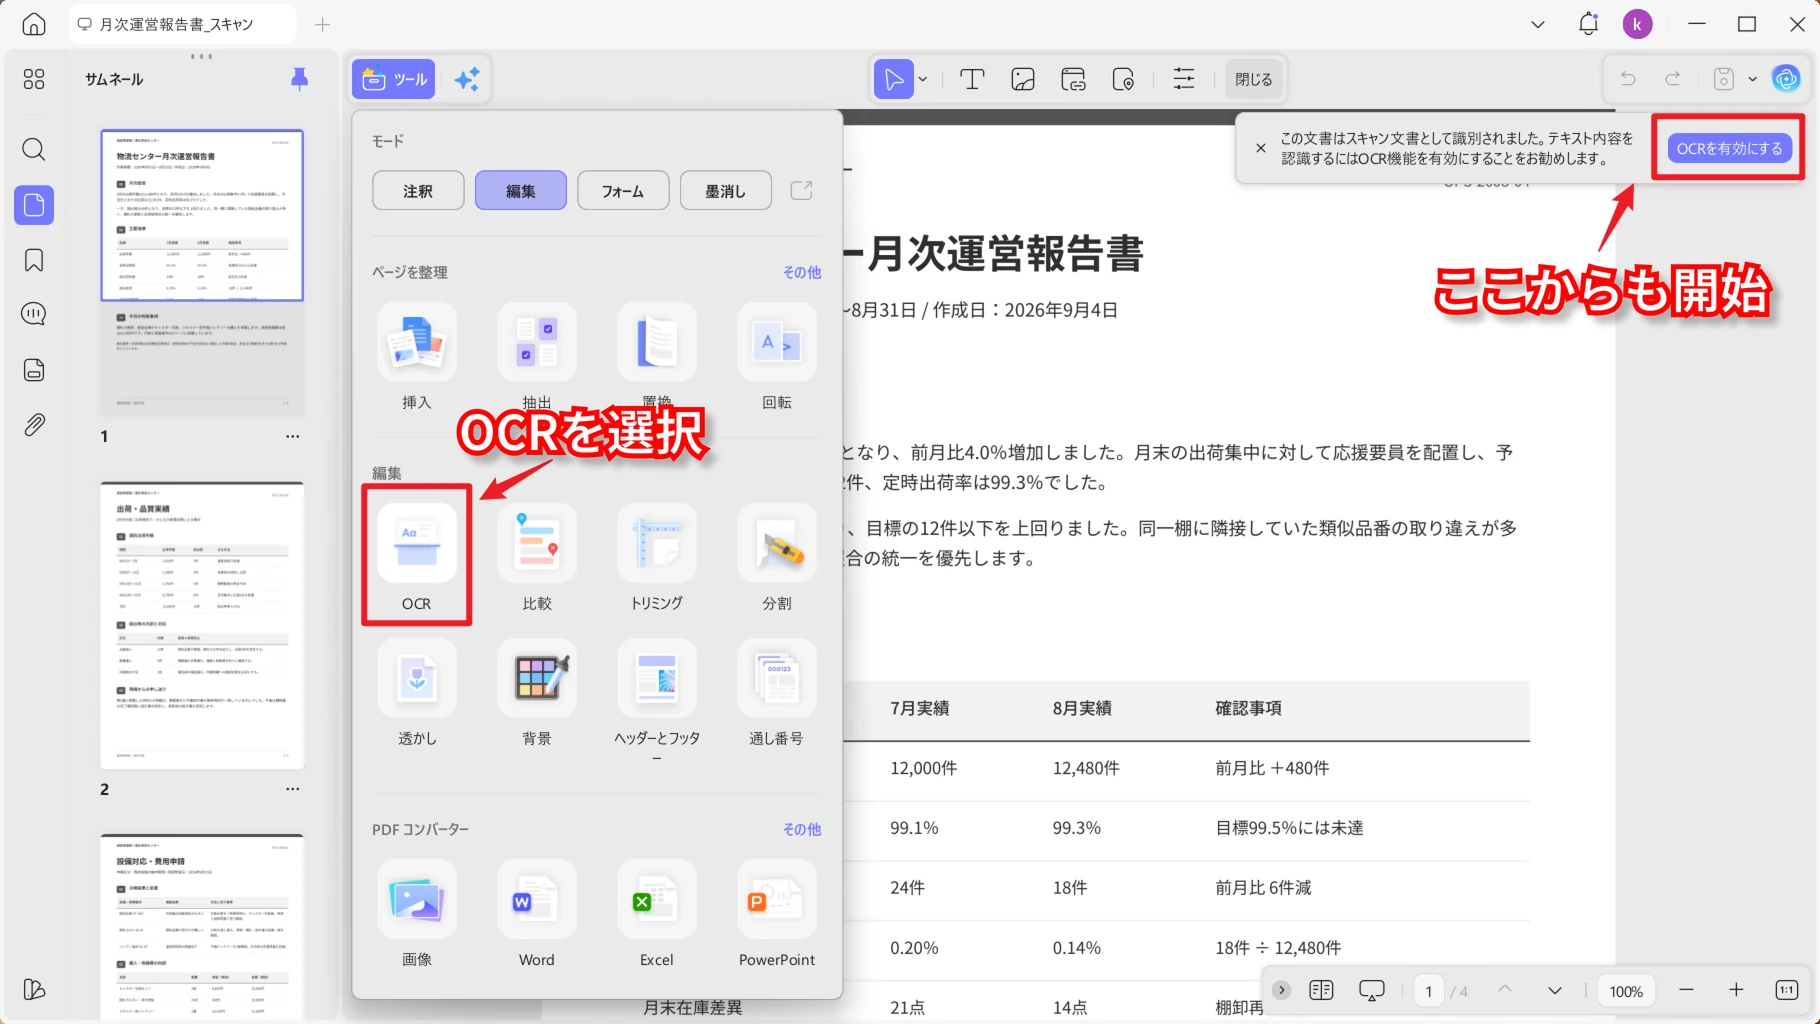
- UPDFで対象のスキャンPDFを開き、「ツール」から「OCR」を選びます。画面右上にスキャン文書の案内が表示された場合は、「OCRを有効にする」からも進めます。
- 「検索可能なPDFのみ(デュアルレイヤーOCR)」を選び、「文書の言語」を「日本語」にします。
- 対象のページ範囲を設定します。まず必要なページで認識結果を確認してから、ほかのページを処理すると、設定違いによるやり直しを減らせます。
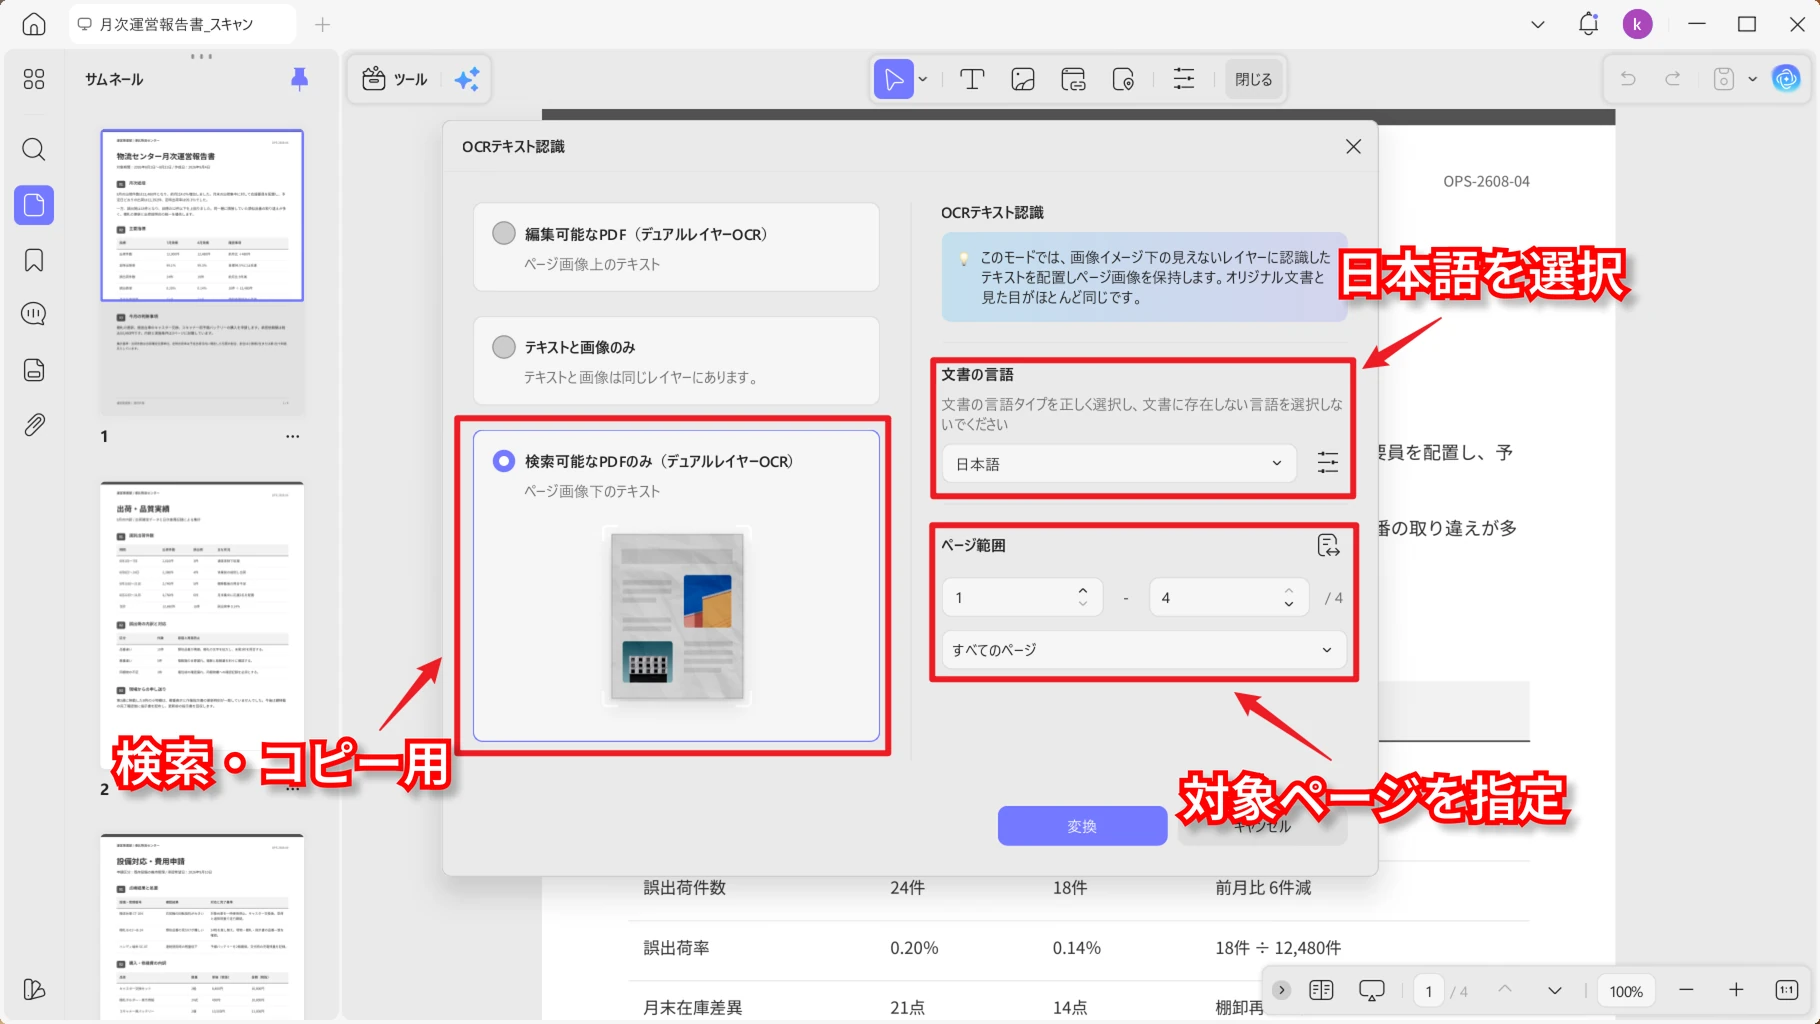
- 「変換」を実行し、処理後のPDFを別名で保存します。元のスキャンPDFは残しておきます。
- 保存したPDFを開き、閲覧状態で本文を選択してメモ帳などに貼り付けます。編集モードで画像全体が選ばれる場合は、先ほどの「閉じる」で編集を終了してから試してください。
一部のページだけを処理すると、選んだページだけが出力される場合があります。保存後のページ数を確認し、元のPDFも残しておきましょう。コピーした文章は原文と照合し、特に氏名・金額・日付・型番と、計算記号や全角・半角の違いを確認してください。
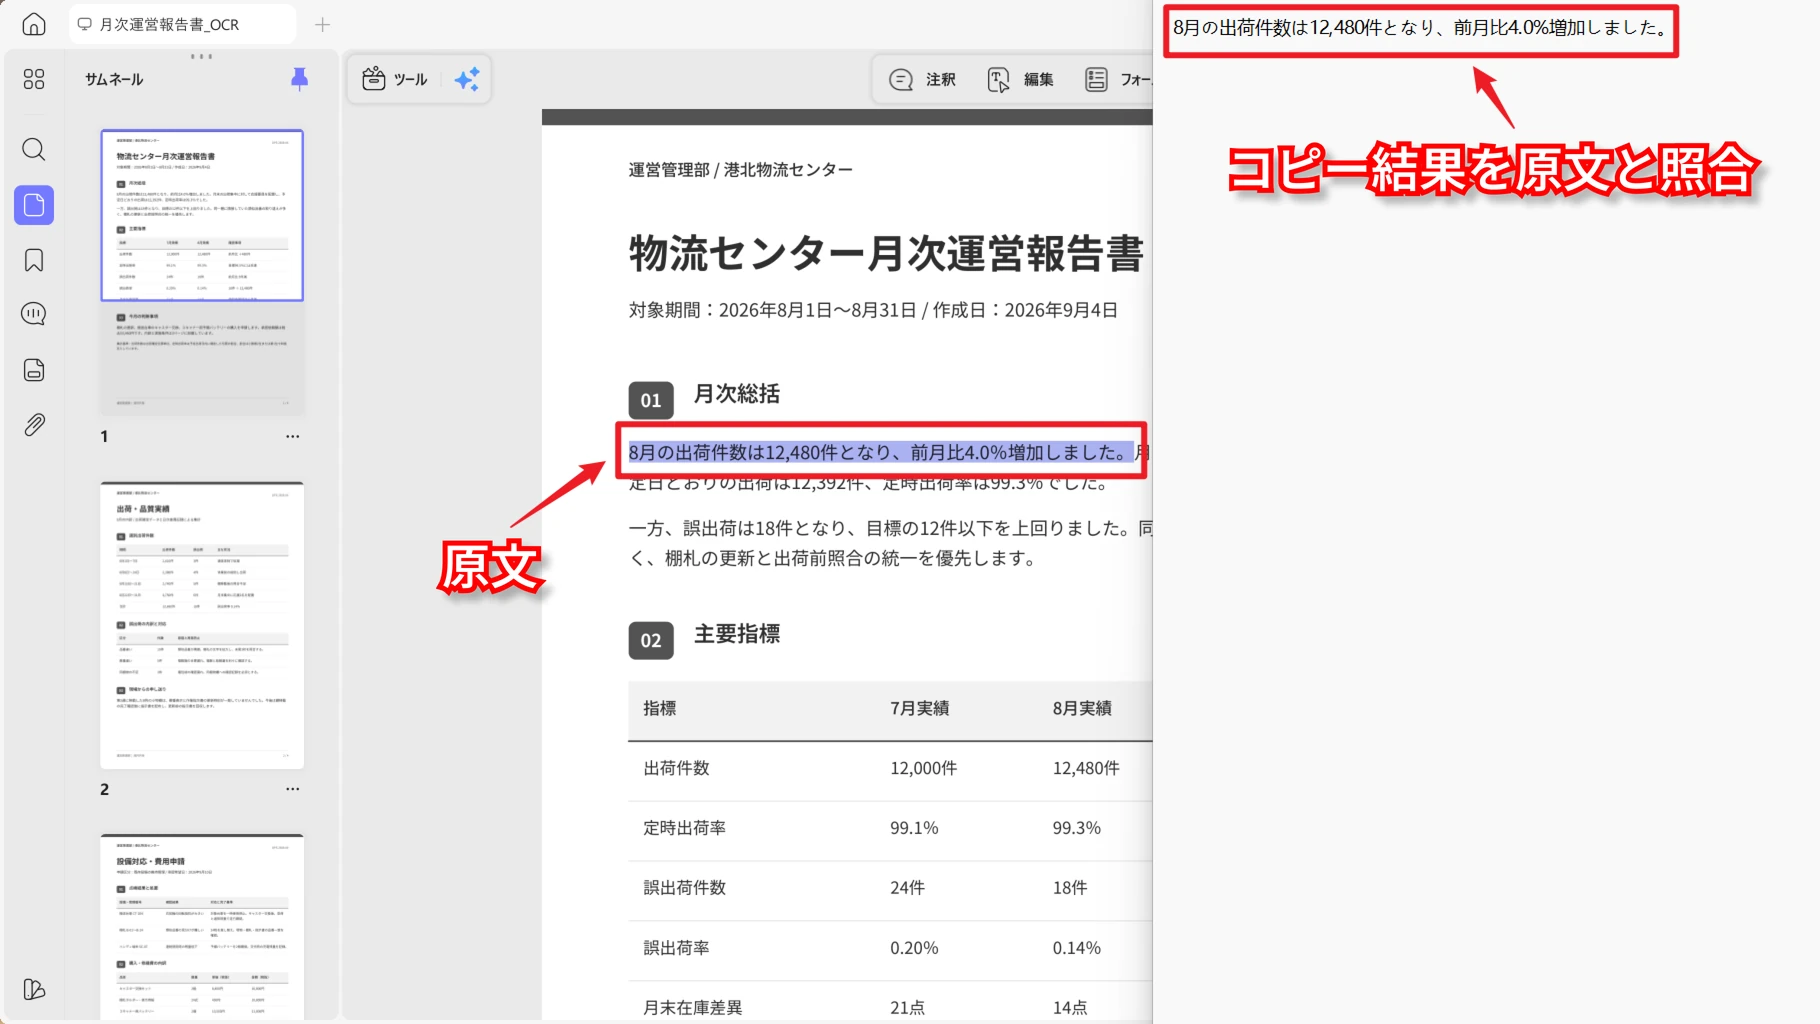
出力方式の違いや認識がうまくいかないときの調整は、PDF OCRの設定と実行手順で詳しく確認できます。
スキャンした資料の文章を再利用したいときは、UPDFのOCRをお試しください。
Windows • macOS • iOS • Android 100%安全
コピー後に文字化け・文字抜けが起きる場合の対処法
画面では正しく読めるのに、貼り付けると四角い記号になる、日本語が抜けて数字だけ残る、といった場合は、PDF内部の文字情報が表示と対応していない可能性があります。文字を選択できることだけでは、正しくコピーできるとは判断できません。
- 文字情報の問題:別の閲覧アプリや貼り付け先でも同じ箇所が化ける場合は、作成者に元のWordなどからPDFを書き出し直してもらうか、元の文章を提供してもらいます。フォントを追加するだけで必ず直るとは限りません。
- OCRの問題:スキャン由来のPDFなら、原画像の傾き・ぼやけ・欠けと、認識言語を確認します。画像自体が読みにくい場合は、鮮明な資料を入手するか再スキャンしてから認識し直します。
元データを入手できず、利用許可のあるPDFから文章を取り出す場合は、必要なページで日本語OCRを試します。それでも文字抜けが残るときは、いったん画像PDFとして別名保存し、そのファイルにOCRをかけ直す方法があります。
- 右上の保存メニューから「画像 PDF」を選び、必要なページ範囲を指定します。
- 「スキャン設定」で「回転角のランダム性」をオフにし、回転角度を0°にします。文字の細部を保つため解像度を上げて保存します。必要なページだけを書き出す場合は、指定範囲外のページを維持するチェックも外します。
- 保存した画像PDFを開き、前述の日本語OCRを実行して、コピー結果を原文と照合します。
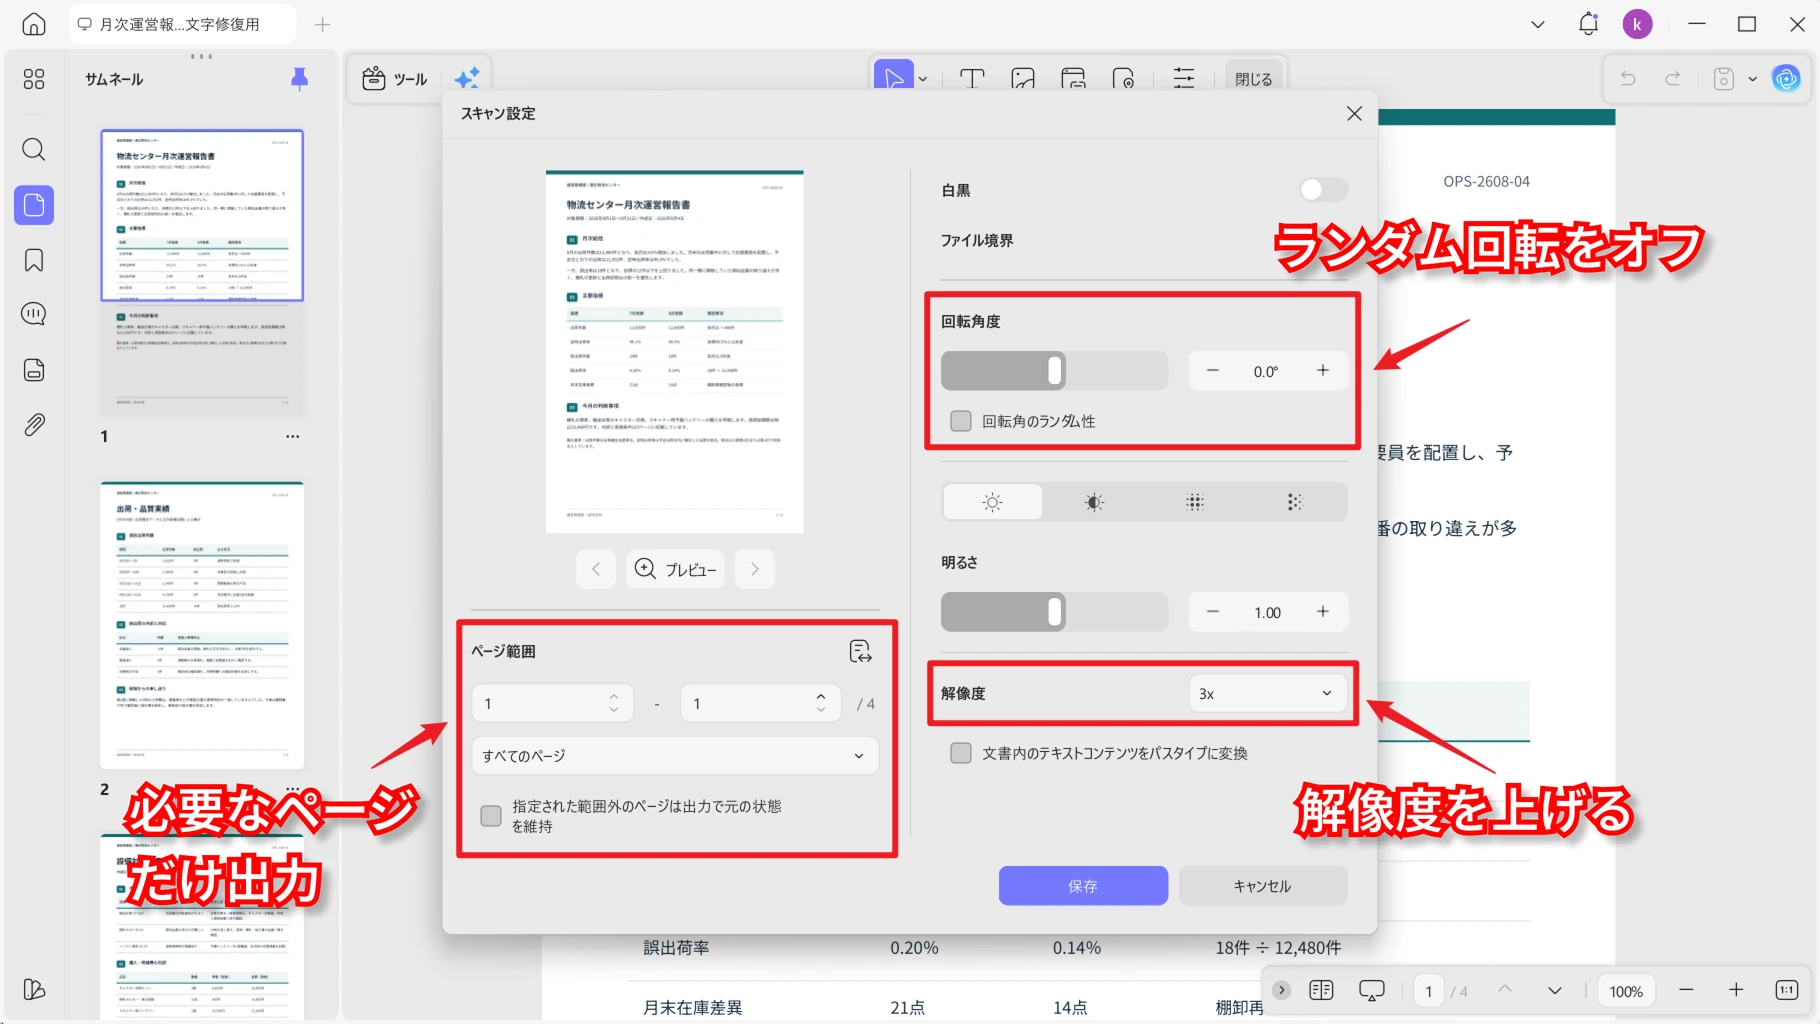
どちらの出力方式でも誤認識が残ることがあるため、数字や記号は原文と照合してください。表示とコピー結果の違いについては、PDFからコピーすると文字化けする場合の対処法も参考にしてください。
補足:コピーできる文章をまとめて取り出す方法
一文ずつなら正しくコピーできても、長文の選択に手間がかかる場合は、テキスト形式へまとめて変換できます。先にコピー権限と短い文章の貼り付け結果を確認してから使いましょう。
- PDFを開き、「ツール」の「PDFコンバーター」から「その他」を選びます。
- 出力形式を「テキスト(.txt)」にし、必要なページ範囲を設定します。スキャン由来のPDFで出力が空白になる場合は、「OCRテキスト認識」をオンにして「日本語」を指定します。
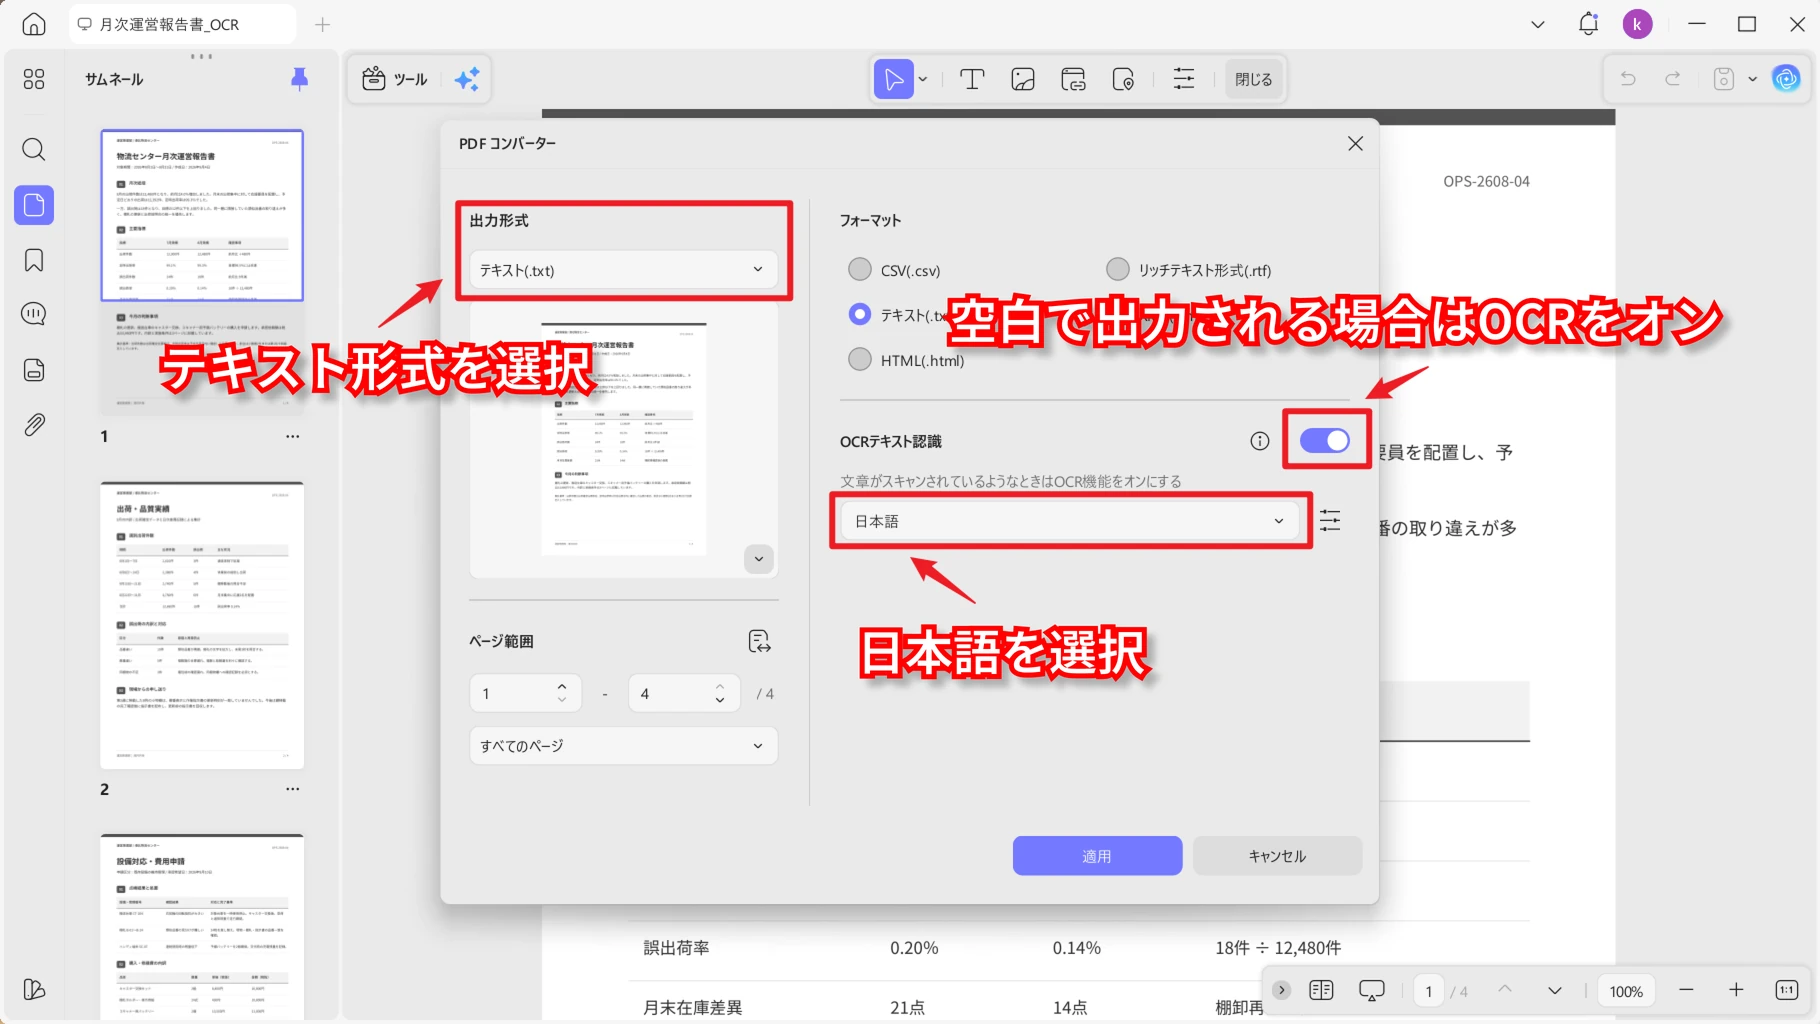
- 「適用」をクリックして保存先を指定します。
- 出力したテキストファイルを開き、必要な文章を取り出します。数字や記号に加え、段組み・表の読み取り順も元のPDFと比較してください。
TXT形式には、元のページの画像や表の罫線、フォントなどのレイアウト情報は保持されません。文章だけを再利用するときに選んでください。変換の詳しい手順は、PDFをテキストに変換する方法をご覧ください。
Windows • macOS • iOS • Android 100%安全
よくある質問
PDFの一部のページだけ文字をコピーできないのはなぜですか?
文字データのあるページと、画像だけのページが混在している場合があります。コピーできないページを確認し、画像だけなら、そのページをOCRの対象にしてください。文字データがあっても結果が化ける場合は、画像だけのページとは区別して原因を調べます。
コピーできないPDFは、作成者に何を依頼すればよいですか?
対象のページと症状、文章の利用目的を伝えます。コピーが禁止されている場合はコピー可能なPDF、画像だけの場合は文字データを含むPDFや元の文書を依頼すると伝わりやすくなります。文字化けする場合は、元の文書からの再出力を依頼し、表示される文章と貼り付け結果の例を添えてください。
まとめ
まず選択方法と貼り付け先を確認し、改善しなければコピー権限と文字情報の有無を調べましょう。画像だけならOCR、制限があるなら作成者への確認、文字化けするなら元データや認識結果の見直しへ進むと、不要な変換を繰り返さずに済みます。
スキャンPDFの文字認識や、長い文章のテキスト化が必要な方は、UPDFのOCR・変換機能を用途に合わせて試してみてください。
Windows • macOS • iOS • Android 100%安全


 高美季子